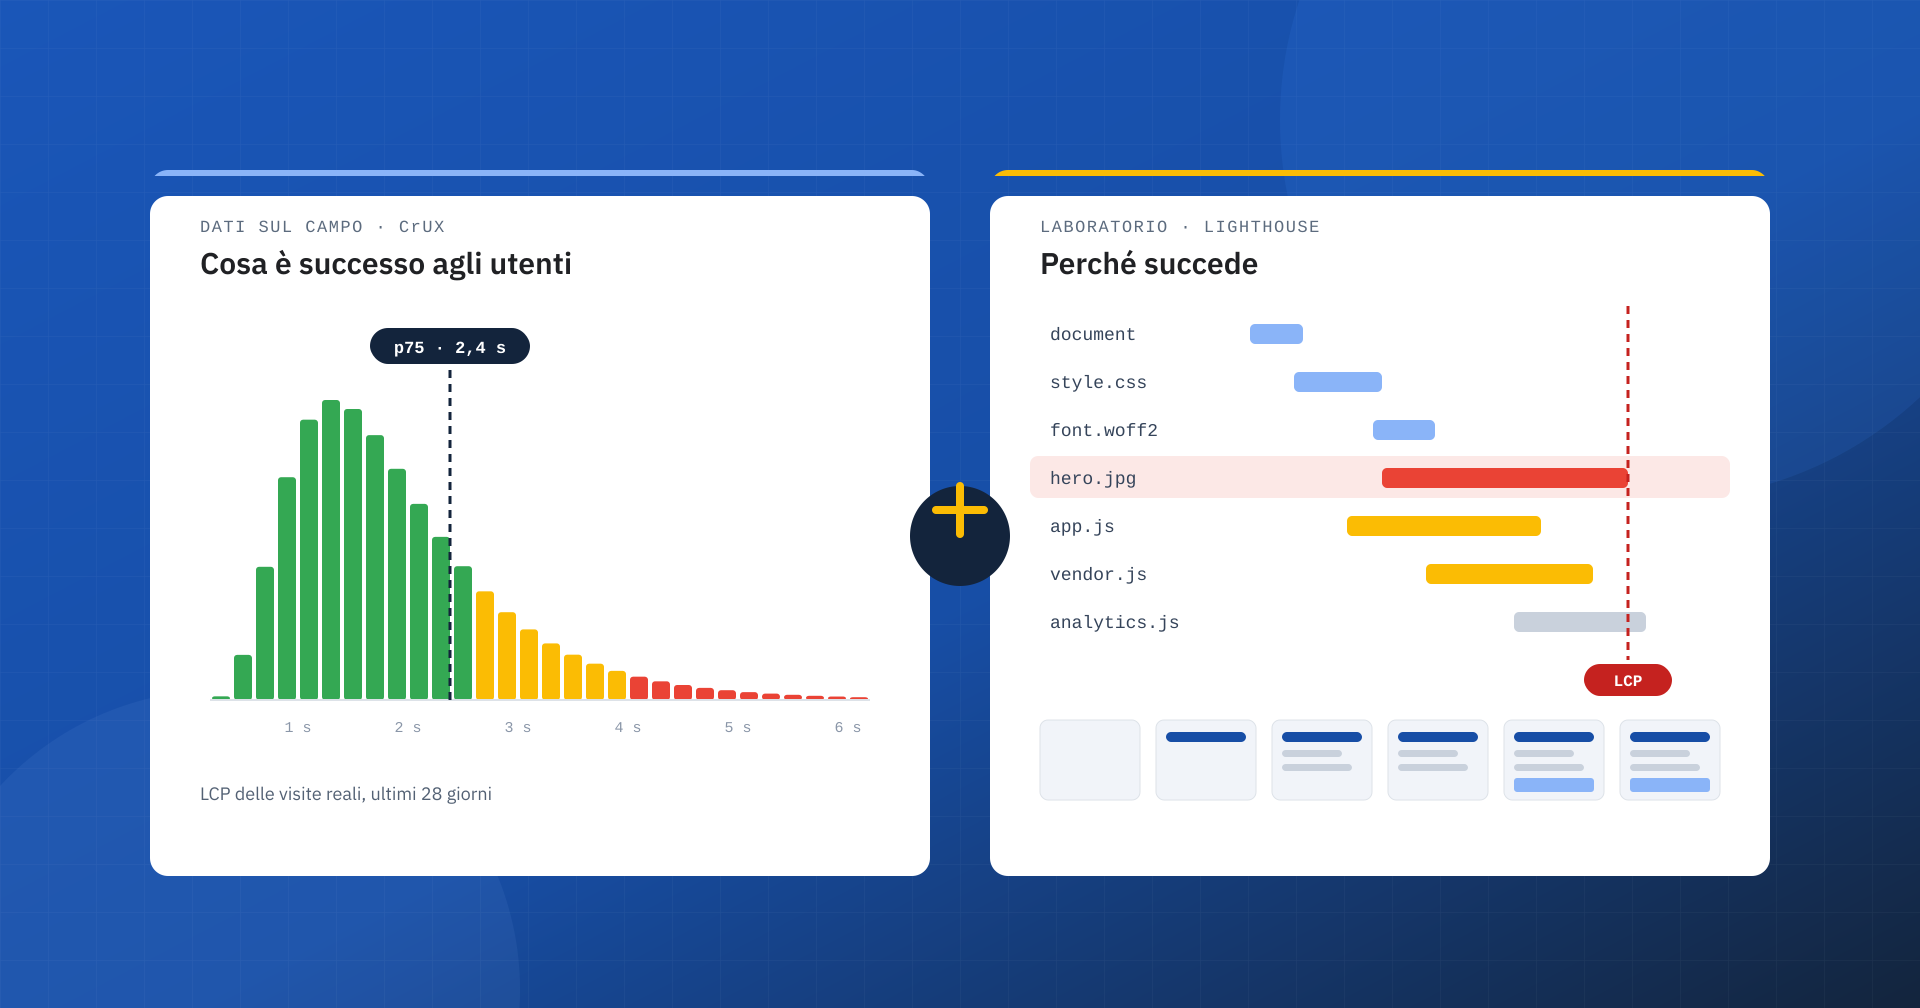
Tra chi si occupa di Web Performance circola un paradosso. Da una parte si riconosce, giustamente, che i dati degli utenti reali sono quelli che contano. Dall’altra si arriva spesso a una conclusione affrettata: se contano solo i dati reali, i test di laboratorio si possono ignorare. Se il Chrome UX Report è verde, che importanza ha un Lighthouse che segnala un LCP lento, un Total Blocking Time alto o un punteggio mediocre?
Ne ha, e parecchia. CrUX e i dati di laboratorio, che per brevità chiameremo LABS, non misurano la stessa cosa e soprattutto non servono allo stesso scopo. I primi raccontano che cosa è successo agli utenti che hanno visitato il sito. I secondi mostrano come si comporta la pagina in condizioni controllate, ripetibili e, se lo vogliamo, più difficili di quelle abituali. Rinunciare a uno dei due significa lavorare con metà delle informazioni.
Il falso mito: CrUX verde, sito veloce
Il ragionamento è noto: Google valuta i Core Web Vitals con i dati reali, quindi l’unico obiettivo è superare la valutazione di CrUX, e la sezione di laboratorio di PageSpeed Insights diventa un dettaglio. Il problema è che si confondono due domande diverse: che cosa è successo, e che cosa potrebbe succedere.
CrUX raccoglie le esperienze reali degli utenti Chrome idonei e le aggrega per URL o per origine. Non calcola una media, ma valuta il 75° percentile: una metrica è “buona” se almeno tre esperienze su quattro rientrano nella soglia. Le soglie attuali sono 2,5 secondi per LCP, 200 millisecondi per INP e 0,1 per CLS. Il percentile limita l’effetto dei casi estremi ed è molto più significativo di una media, ma proprio perché descrive una distribuzione non garantisce che ogni utente stia navigando velocemente: dice solo che la maggioranza lo fa.
Chi stai misurando davvero
Prendiamo un sito il cui pubblico arriva in gran parte dalle grandi città, con smartphone recenti collegati in fibra, Wi-Fi veloce o 5G a bassa latenza. È questa popolazione a dominare le esperienze raccolte da CrUX. Se nove utenti su dieci navigano in condizioni favorevoli, la pagina può ottenere valori eccellenti anche se, in assoluto, è tutt’altro che leggera.
Ora apriamo lo stesso sito da una zona con copertura mobile debole, su una rete 4G congestionata e con uno smartphone di fascia media. Un’immagine principale da 800 KB, quattro font da domini esterni, 700 KB di JavaScript, uno script pubblicitario, il banner del consenso e qualche widget di terze parti erano quasi invisibili in fibra; qui diventano secondi di attesa. Il sito non è diventato più pesante: lo era già. Erano la rete e i dispositivi del pubblico abituale ad attutirne il peso.
La geografia è solo l’esempio più intuitivo. Contano il dispositivo, la potenza del processore, il tipo di rete, la latenza, la cache del browser, il comportamento di chi naviga e molti altri fattori. Una parte del pubblico, inoltre, non compare affatto nei dati: Chrome su iPhone e gli altri browser non contribuiscono a CrUX.
CrUX descrive correttamente il pubblico che hai oggi. Non tutti gli utenti che potresti avere domani.
Cosa dicono, e cosa non dicono, i dati sul campo
I dati di CrUX sono rappresentativi delle esperienze effettivamente raccolte per quel sito, non di ogni possibile condizione di navigazione. Ed è giusto così: il compito dei dati sul campo è raccontare il mondo reale. L’errore nasce quando si trasforma questa caratteristica in una conclusione assoluta. “CrUX è verde, quindi il sito è veloce” è un’affermazione diversa da quella corretta: “almeno il 75% delle esperienze raccolte negli ultimi 28 giorni rientra oggi nelle soglie buone”.
C’è poi il fattore tempo. I dati di PageSpeed Insights coprono una finestra mobile di 28 giorni: una modifica che peggiora la pagina oggi compare subito in un test di laboratorio, mentre nei dati reali emerge gradualmente, man mano che le nuove esperienze sostituiscono le vecchie. Non è un difetto di CrUX, ma la conseguenza naturale di una misura aggregata nel tempo.
A cosa servono i dati di laboratorio
Il laboratorio risponde a un’altra domanda. Non “come hanno navigato i nostri visitatori?”, ma “come si comporta questa pagina se togliamo le variabili esterne e la sottoponiamo a uno scenario riproducibile?”. Lighthouse, lo stesso motore usato da PageSpeed Insights per la sezione di laboratorio, carica la pagina con dispositivo, rete e processore simulati e ne scompone il caricamento.
È così che emergono problemi difficili da vedere nel dato aggregato: risorse che bloccano il rendering, JavaScript eccessivo, task lunghi sul thread principale, immagini sovradimensionate, una catena di richieste troppo lunga prima dell’elemento LCP, CSS inutilizzato, script di terze parti. E il laboratorio ha un vantaggio che i dati reali non possono offrire: la ripetibilità. Prima e dopo un intervento si possono confrontare condizioni equivalenti, in pochi minuti.
Dire che un dato di laboratorio è “finto” perché sintetico è un errore di prospettiva. Un crash test non riproduce ogni incidente possibile, ma nessuno lo considera inutile: mette il veicolo in una condizione nota e osserva come reagisce. Allo stesso modo, un sito che mantiene LCP basso, poco JavaScript e thread principale libero anche in condizioni più severe di quelle del suo pubblico abituale ha qualcosa in più.
Il margine prestazionale
Quel qualcosa in più è il margine. Immaginiamo due siti con lo stesso LCP di 2 secondi nei dati reali. Il primo è ben costruito: HTML generato in fretta, cache efficace, immagini compresse, poche risorse critiche, poco JavaScript, un server che risponde in pochi millisecondi. Il secondo arriva ai 2 secondi soprattutto perché il suo pubblico usa hardware recente e connessioni velocissime, mentre la pagina pesa diversi megabyte e porta con sé molto JavaScript.
Guardando solo CrUX sembrano equivalenti. Dal punto di vista dell’ingegneria delle performance non lo sono affatto: il primo continua a funzionare bene quando le condizioni peggiorano, il secondo si degrada rapidamente appena aumentano latenza, congestione della rete o carico del processore. Il laboratorio è lo strumento che rende visibile questa differenza.
LABS rosso e CrUX verde
È la situazione che fa discutere di più: il sito supera i Core Web Vitals sul campo, ma Lighthouse segnala prestazioni mediocri. Bisogna intervenire su ogni avviso? No, e di certo non inseguendo il 100: il punteggio non è un obiettivo in sé. Ma ignorare il report sarebbe altrettanto sbagliato. Un laboratorio nettamente negativo indica spesso un sito con poco margine, le cui buone prestazioni reali dipendono in parte dalle condizioni favorevoli del pubblico. Se il test mostra 2 MB di JavaScript, immagini enormi o un LCP che arriva dopo una lunga catena di richieste, il fatto che gli utenti di oggi riescano a compensare non trasforma quei problemi in buone pratiche.
LABS verde e CrUX rosso
Succede anche il contrario: Lighthouse è eccellente, ma i dati reali mostrano LCP, INP o CLS insufficienti. Il laboratorio dice che nello scenario del test la pagina si comporta bene; CrUX dice che nel mondo reale qualcosa va storto. Entrano in gioco fattori che un singolo caricamento sintetico non rappresenta: interazioni successive, contenuti personalizzati, banner del consenso, pubblicità, script caricati solo in certe condizioni, dispositivi molto lenti. L’INP, in particolare, dipende dalle interazioni reali, che un test automatico non compie: è il motivo per cui tecniche come il delay del JavaScript al primo clic possono migliorare il laboratorio e peggiorare il campo. E non va dimenticato che esistono configurazioni capaci di servire al test una pagina diversa da quella degli utenti. In questi casi CrUX è il punto di partenza: indica il problema che il laboratorio dovrà riprodurre e spiegare.
Il flusso di lavoro: CrUX, LABS, intervento, CrUX
Chiedersi quale dei due dati sia “quello giusto” è la domanda sbagliata: lo sono entrambi, perché rispondono a domande diverse. Un processo di ottimizzazione sensato usa i dati sul campo per individuare i problemi e pesarne l’impatto, e il laboratorio per capirne le cause.
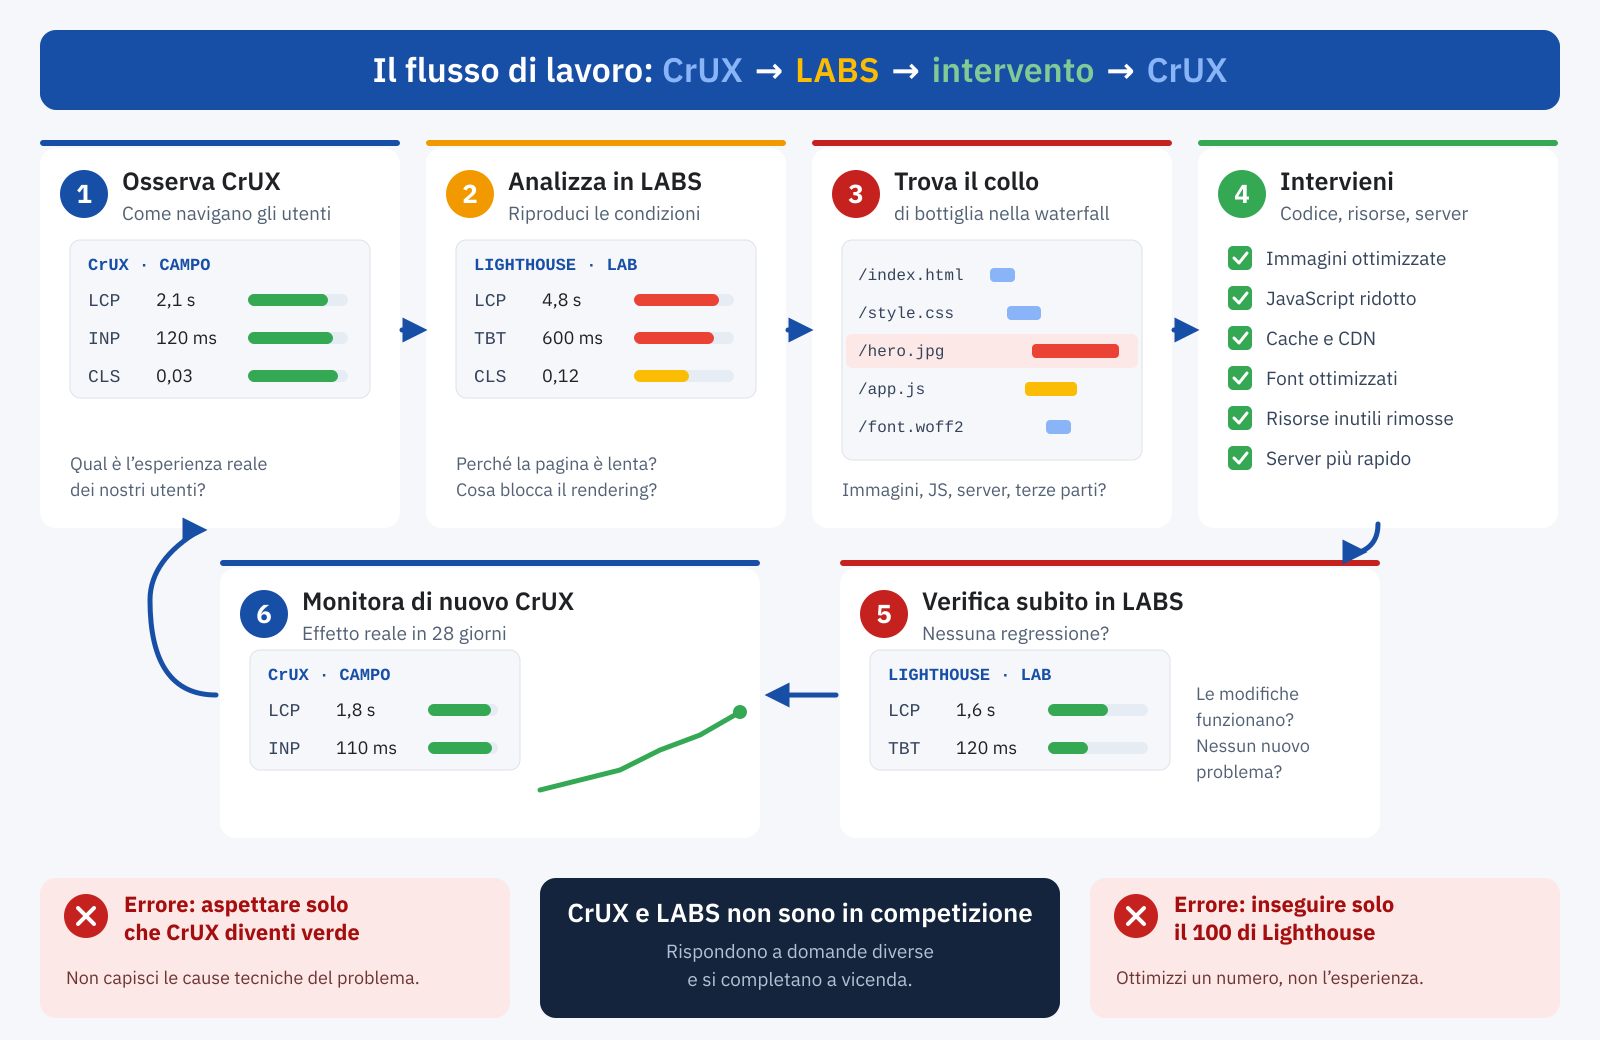
- Osservare i dati CrUX per capire come navigano davvero gli utenti e quali pagine e metriche sono critiche.
- Analizzare le pagine in laboratorio, cercando di riprodurre le condizioni problematiche.
- Individuare il collo di bottiglia tecnico nella waterfall, nel thread principale o nel server.
- Applicare l’intervento.
- Verificare subito in laboratorio che non siano state introdotte regressioni.
- Monitorare i dati reali nelle settimane successive per misurare l’effetto sugli utenti.
È un approccio molto più razionale sia dell’attesa passiva che il riquadro dei dati reali diventi verde, sia della rincorsa compulsiva al 100 di Lighthouse senza chiedersi se gli utenti percepiranno davvero la differenza.
Non dimenticare il server
Le buone performance nascono dall’intero stack, non solo dal front-end. Il browser non può costruire una pagina che il server non ha ancora iniziato a inviare: query lente, PHP sovraccarico, assenza di cache di pagina, object cache mal configurata o risorse sottodimensionate allungano il tempo di risposta. Il TTFB non è un Core Web Vital, ma si propaga lungo tutta la catena di caricamento e pesa soprattutto su LCP. Con utenti vicini al datacenter e ben connessi una parte di queste inefficienze resta nascosta; i test controllati, con waterfall e condizioni di rete diverse, permettono di separare le responsabilità del back-end da quelle del front-end.
Quando il pubblico cambia all’improvviso
C’è un ultimo aspetto che mostra quanto sia rischioso contare solo sulle condizioni medie del proprio pubblico: la composizione del traffico può cambiare in fretta. Una campagna internazionale, un contenuto che diventa virale, la crescita in un nuovo mercato portano utenti più lontani dal server, con reti più lente e dispositivi meno potenti. In teoria lo stesso effetto potrebbe essere provocato di proposito, acquistando traffico a basso costo da aree con connettività peggiore per danneggiare i dati di un concorrente. Non esiste alcuna garanzia che un’operazione del genere funzioni, e i Core Web Vitals sono solo uno dei tanti segnali usati da Google, ma lo scenario aiuta a capire il punto.
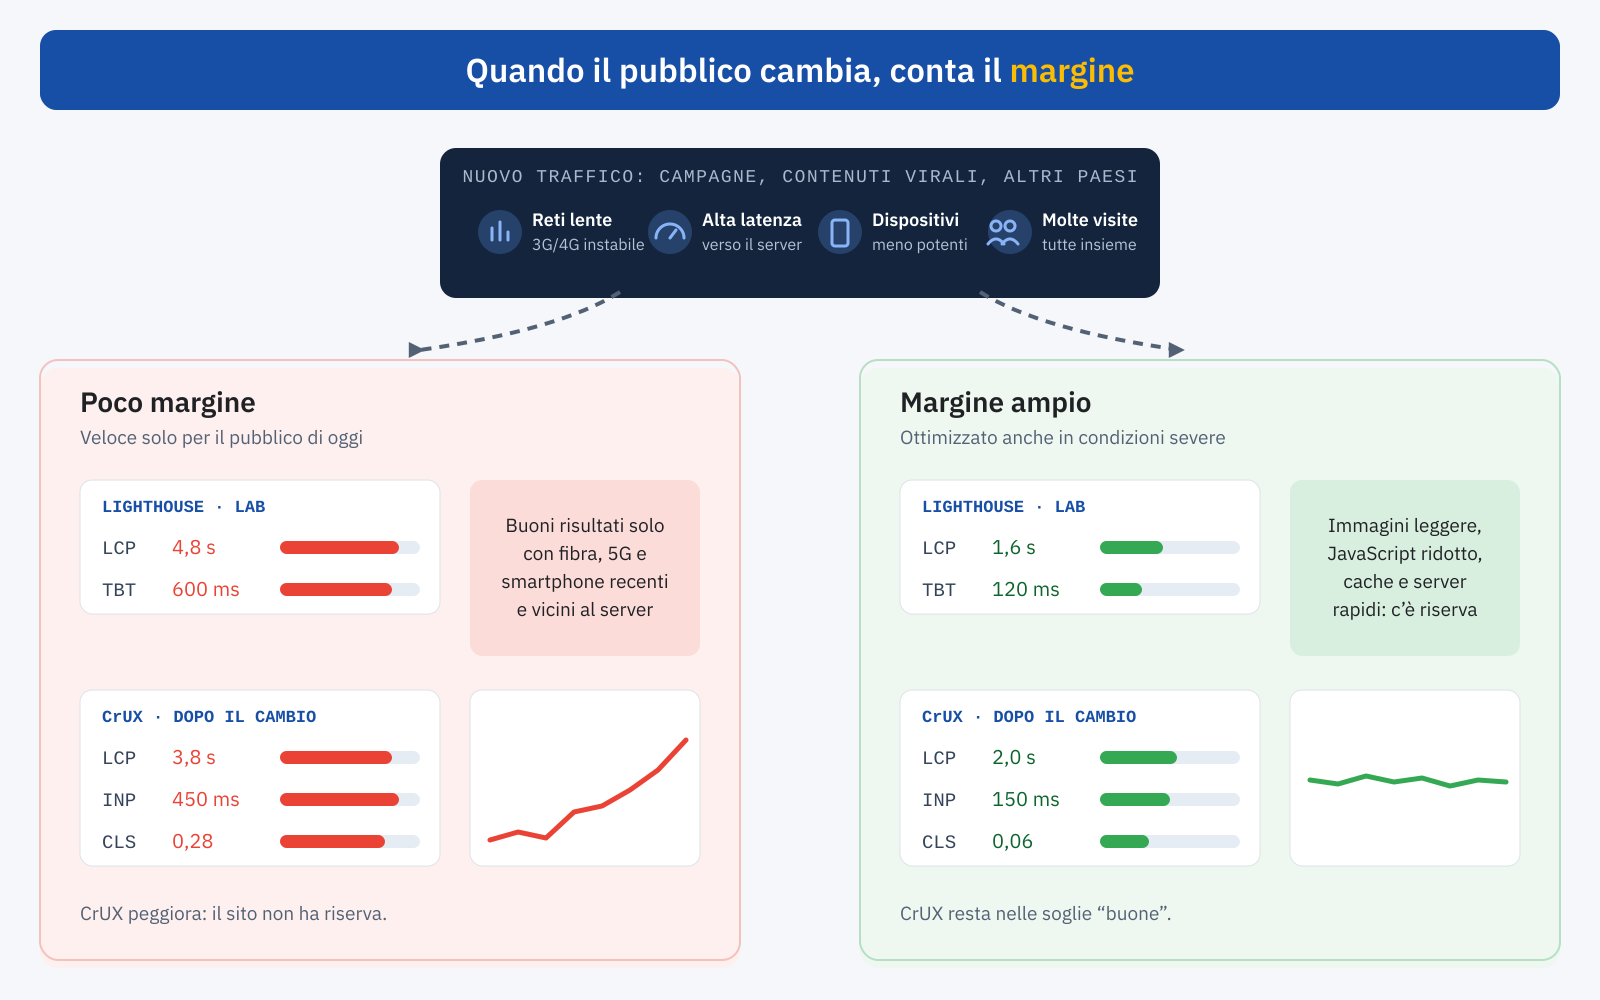
CrUX non usa tutte le visite e non fa una media: considera solo gli utenti idonei e valuta il 75° percentile. Non esiste quindi una regola del tipo “tante visite lente valgono tanti punti persi”. Ma se una quota sufficiente di nuove esperienze più lente entra nel campione, la distribuzione cambia. Un sito che in laboratorio ha già poco margine, con un LCP vicino alla soglia, centinaia di richieste e immagini pesanti, supera rapidamente i limiti appena le condizioni favorevoli vengono meno. Un sito ottimizzato anche per scenari severi ha invece una riserva: qualche centinaio di millisecondi di latenza in più non lo fa uscire dalle soglie. Curare i dati di laboratorio diventa così una forma di irrobustimento, non contro un algoritmo, ma contro l’idea di un sito veloce solo finché nulla cambia.
In sintesi
Non bisogna scegliere tra CrUX e LABS, ma conoscerne limiti e vantaggi. CrUX racconta che cosa è successo agli utenti reali, sulle reti e sui dispositivi che hanno usato davvero: è il riferimento per la valutazione dei Core Web Vitals. Il laboratorio permette di creare condizioni controllate, confrontare il prima e il dopo, trovare i colli di bottiglia e misurare il margine di una pagina. Se il tuo pubblico naviga quasi solo in fibra e con smartphone di ultima generazione, CrUX può essere ottimo anche con inefficienze importanti: non sta sbagliando, sta descrivendo il pubblico di oggi. Il laboratorio ti aiuta a capire che cosa succederà domani, o che cosa sta già succedendo agli utenti meno fortunati.
E poi c’è il test più semplice di tutti: usare il sito come lo usano le persone. Aprirlo dallo smartphone in un locale affollato, in un edificio con poca copertura, in vacanza dove il segnale va e viene. È lì che emergono immagini che arrivano tardi, elementi che si spostano, pulsanti che non rispondono. La simulazione della rete lenta nei DevTools resta preziosa, ma non sostituisce l’esperienza diretta: se il sito sembra lento a te, in condizioni reali, lo è anche per una parte dei tuoi utenti. Un sito davvero veloce non è quello con tre indicatori verdi oggi, ma quello che resta veloce quando la rete rallenta, il dispositivo è meno potente e il pubblico cambia.
