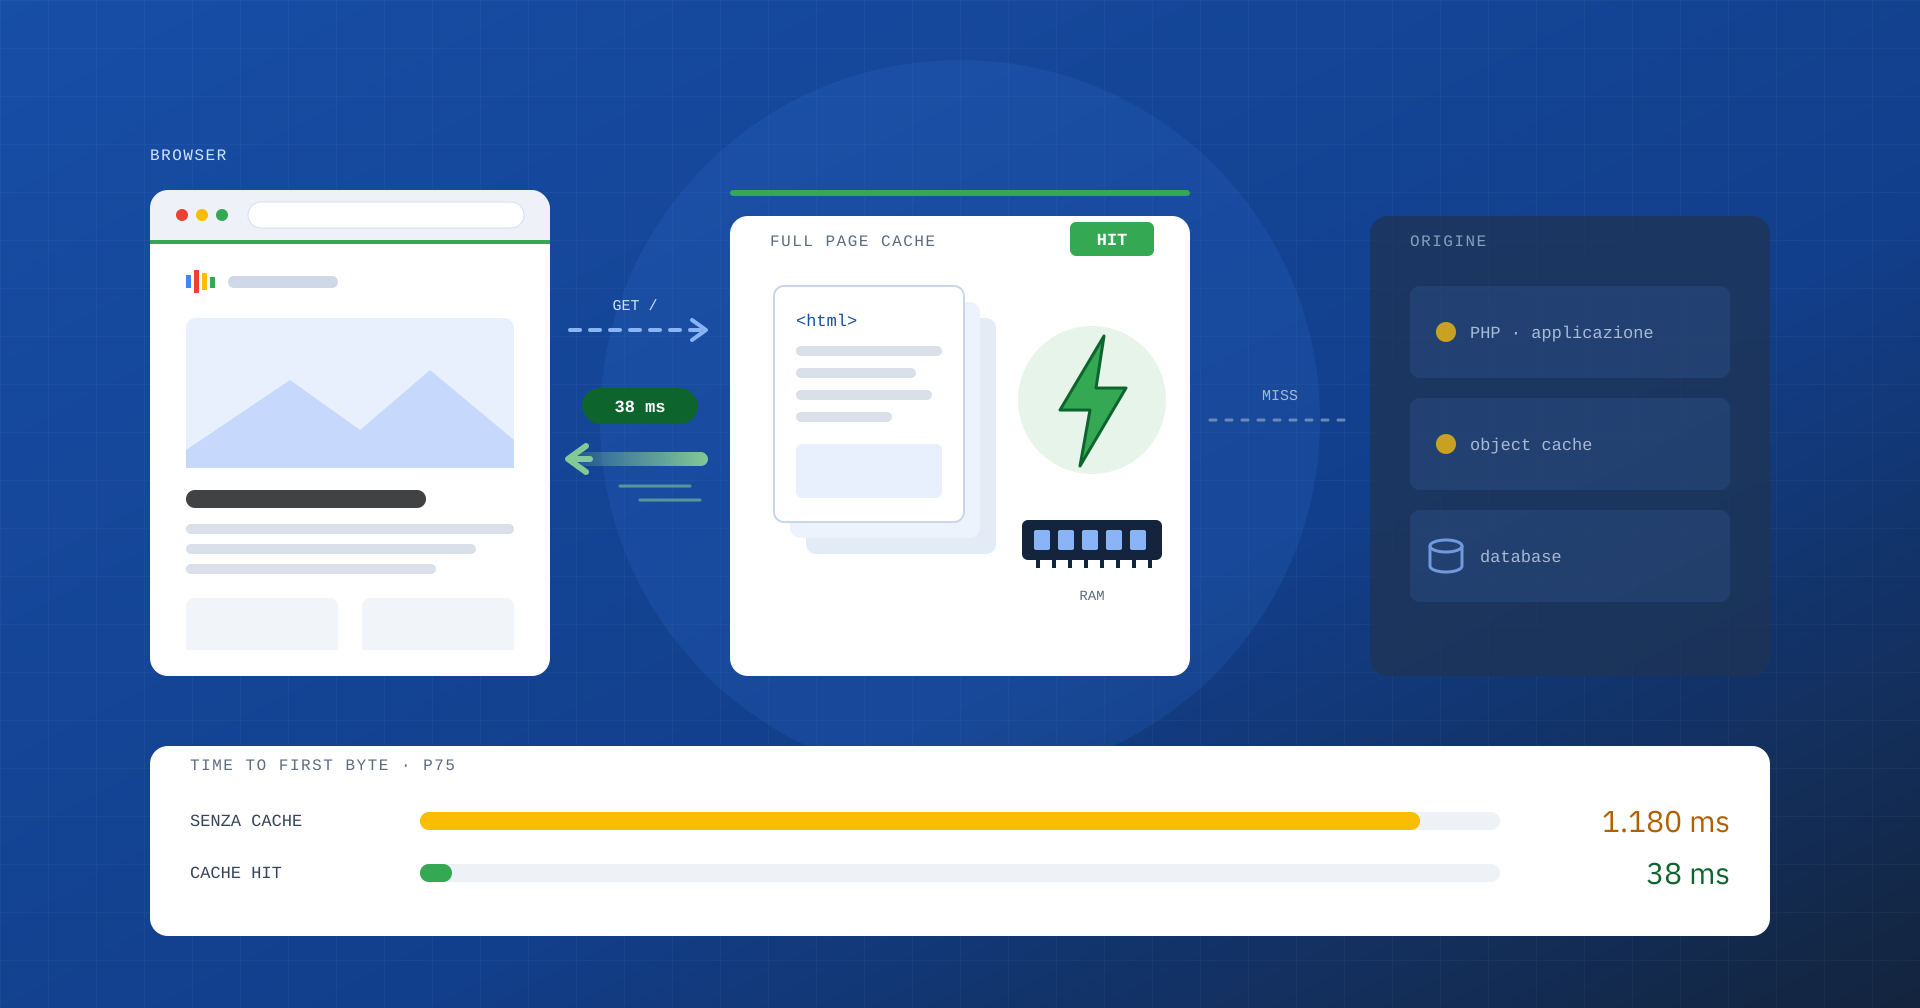
Prima che il browser possa mostrare anche un solo pixel, deve ricevere dal server il primo byte della pagina. Il tempo che passa tra la richiesta e quel primo byte ha un nome, TTFB, ed è la fondamenta su cui poggiano tutte le altre metriche di velocità. Se le fondamenta sono lente, nessuna ottimizzazione del front-end potrà rendere il sito veloce davvero.
In questo articolo vediamo che cosa misura il TTFB, perché incide direttamente su LCP e sui risultati di business, e come la cache di pagina, con Varnish come riferimento per i progetti di fascia enterprise, permetta di ridurlo di un ordine di grandezza. Vediamo anche i casi in cui la cache da sola non basta.
Che cos’è il TTFB
Il Time to First Byte misura l’intervallo tra l’inizio della navigazione e l’arrivo del primo byte della risposta HTML. Non è solo “il tempo del server”: comprende eventuali redirect, la risoluzione DNS, l’apertura della connessione TCP, la negoziazione TLS e infine il tempo che il server impiega a elaborare la richiesta e a iniziare a rispondere.
| Fase | Da cosa dipende |
|---|---|
| Redirect | Catene di reindirizzamenti, ad esempio da http a https e da dominio senza www a www |
| DNS | Qualità del provider DNS e durata della cache dei record |
| Connessione e TLS | Distanza fisica dal server, protocollo (HTTP/2, HTTP/3), configurazione TLS |
| Elaborazione | Cache di pagina, codice dell’applicazione, database, risorse del server |
Come riferimento, un TTFB entro 0,8 secondi al 75° percentile è considerato buono, mentre oltre 1,8 secondi è da migliorare con urgenza. Il TTFB non è uno dei tre Core Web Vitals, ma è una metrica di diagnosi fondamentale: ogni millisecondo speso prima del primo byte si somma a FCP e a LCP, e lascia meno margine a tutto il resto.
Perché il TTFB pesa sul business
Immaginiamo un e-commerce con un TTFB di 1,5 secondi. Per restare entro i 2,5 secondi di un buon LCP, il browser ha a disposizione un solo secondo per scaricare fogli di stile, font e immagine principale, e per disegnare la pagina. Su uno smartphone con una connessione mobile media è un obiettivo quasi irraggiungibile. Il risultato è un LCP scarso che nessun intervento sulle immagini o sul JavaScript potrà correggere del tutto.
Le conseguenze si vedono nei numeri: più abbandoni nelle prime fasi della visita, landing page delle campagne che sprecano una parte dei clic pagati, pagine di categoria e schede prodotto che rispondono lente proprio quando arriva il traffico. E c’è un effetto meno visibile ma altrettanto concreto: un server che impiega troppo tempo a generare ogni pagina esaurisce prima le proprie risorse. Nei momenti di picco, come una promozione, un invio di newsletter o una notizia che diventa virale, il TTFB non cresce in modo lineare ma esplode, fino agli errori e ai fermi.
Anche i motori di ricerca ne risentono: un server lento limita la quantità di pagine che i crawler riescono a scansionare nel tempo a disposizione, un problema che nei siti con cataloghi o archivi ampi si traduce in contenuti indicizzati con ritardo.
La cache di pagina: il principio
In un CMS come WordPress, WooCommerce, Magento o Joomla, ogni pagina viene normalmente costruita al momento: il server esegue il codice PHP, interroga il database, assembla template e contenuti e solo alla fine invia l’HTML. È un lavoro che può richiedere centinaia di millisecondi o qualche secondo, e che viene ripetuto identico per ogni visitatore.
La cache di pagina, o Full Page Cache, parte da un’osservazione semplice: per la grande maggioranza delle visite l’HTML generato è lo stesso. Conviene quindi generarlo una volta, conservarlo e servire la copia già pronta alle richieste successive. Quando la pagina richiesta è in cache si parla di HIT e la risposta parte in pochi millisecondi; quando non lo è si parla di MISS e la richiesta prosegue verso l’applicazione, che genera la pagina e la consegna alla cache per le volte successive.
Due parametri determinano l’efficacia di una cache: il tasso di HIT, cioè la percentuale di richieste servite senza scomodare l’applicazione, e la strategia di invalidazione, cioè il modo in cui una pagina viene aggiornata quando il contenuto cambia. Una cache con un tasso di HIT basso o che serve contenuti vecchi è, rispettivamente, inutile o dannosa.
Varnish, lo standard enterprise per la Full Page Cache
Tra le soluzioni disponibili, Varnish Cache è da anni la prima scelta per i progetti di fascia enterprise: grandi testate, e-commerce con cataloghi estesi, portali con picchi di traffico imprevedibili. È un reverse proxy HTTP che si colloca davanti al web server e conserva le pagine direttamente in memoria RAM, rispondendo senza toccare né PHP né il database. Su hardware adeguato serve decine di migliaia di richieste al secondo con tempi di risposta di pochi millisecondi.
Le ragioni del suo successo, però, non stanno solo nella velocità:
- VCL, un linguaggio di configurazione vero. La Varnish Configuration Language permette di decidere richiesta per richiesta cosa mettere in cache, per quanto tempo, quali cookie ignorare e quali parametri dell’URL normalizzare. È la differenza tra una cache generica e una cache disegnata sull’applicazione.
- Invalidazione precisa. Con PURGE e BAN è possibile rimuovere una singola pagina o interi gruppi di pagine nel momento in cui un contenuto cambia, ad esempio quando si aggiorna un prezzo o si pubblica un articolo, senza svuotare tutta la cache.
- Grace mode. Quando una pagina scade, Varnish può continuare a servire la copia precedente mentre ne richiede una nuova in background. Se l’applicazione è lenta o momentaneamente irraggiungibile, gli utenti continuano a ricevere pagine veloci invece di un errore.
- Protezione dei picchi. Più richieste simultanee per la stessa pagina non ancora in cache vengono unite in una sola verso l’applicazione, evitando che un picco di traffico si trasformi in centinaia di elaborazioni identiche.
- ESI (Edge Side Includes). Una pagina può essere composta da frammenti con regole di cache diverse, così una parte personalizzata non impedisce di mettere in cache tutto il resto.
Va tenuto presente che la versione open source di Varnish non gestisce direttamente HTTPS: in produzione si affianca a un terminatore TLS, come Nginx o Hitch, che riceve le connessioni cifrate e le passa a Varnish. È un’architettura consolidata, ma richiede di essere progettata e mantenuta da chi conosce bene entrambe le componenti.
Le alternative e quando hanno senso
Varnish non è l’unica strada, e non sempre è la più adatta. Le opzioni principali sono tre:
- Plugin di cache del CMS. Salvano le pagine su disco e le servono tramite PHP o regole del web server. Sono semplici da attivare e adatti a siti piccoli, ma la richiesta attraversa comunque parte dello stack e le regole di esclusione sono spesso generiche.
- Cache del web server, come la FastCGI cache di Nginx. Più efficiente dei plugin e senza componenti aggiuntivi, ma con strumenti di invalidazione e di logica condizionale meno ricchi di VCL.
- Cache sulla CDN. Porta le pagine vicino agli utenti, riducendo anche la latenza di rete. È un complemento eccellente per un pubblico internazionale, a patto di governare con attenzione invalidazione e contenuti personalizzati. Spesso la configurazione più robusta combina CDN e Varnish sull’origine.
Quando la cache non basta
La cache di pagina risolve il TTFB per le visite anonime, ma non tutte le visite lo sono. Gli utenti che hanno effettuato l’accesso, chi ha prodotti nel carrello, chi sta completando il checkout ricevono pagine personalizzate che non possono essere condivise. In un e-commerce sono proprio le persone più vicine all’acquisto.
Ci sono poi errori di configurazione molto comuni che abbassano il tasso di HIT senza che nessuno se ne accorga: un cookie impostato a tutti i visitatori che fa scavalcare la cache, i parametri delle campagne come utm_source o gclid che creano una copia diversa della stessa pagina per ogni clic, tempi di scadenza troppo brevi, invalidazioni che svuotano l’intera cache a ogni modifica.
Per questo il percorso “MISS” deve essere veloce quanto quello “HIT” è istantaneo. Significa lavorare sull’origine: versione recente di PHP con OPcache dimensionata correttamente, object cache persistente come Redis per evitare query ripetute, database ottimizzato e ripulito da opzioni caricate a ogni richiesta, sessioni e dati temporanei accumulati negli anni, e un’applicazione che non esegue lavoro inutile a ogni pagina.
Come misurarlo
Il TTFB reale degli utenti è disponibile nel Chrome UX Report, sia per l’intera origine sia per le singole pagine con traffico sufficiente. Per la diagnosi, invece, serve osservare le singole risposte. Un primo controllo si fa con una semplice riga di comando:
curl -s -o /dev/null -w "DNS %{time_namelookup}s · TLS %{time_appconnect}s · TTFB %{time_starttransfer}s\n" https://www.iltuosito.it/Ripetendo la richiesta più volte si vede subito la differenza tra la prima risposta, spesso un MISS, e le successive servite dalla cache. Le intestazioni di risposta, come X-Cache o Age, dicono se la pagina arriva dalla cache e da quanto tempo vi si trova, mentre l’intestazione Server-Timing permette all’applicazione di dichiarare quanto tempo ha speso in ciascuna fase. Sul server, strumenti come varnishstat e varnishlog mostrano il tasso di HIT complessivo e il motivo di ogni MISS.
In sintesi
Il TTFB è il punto di partenza di ogni pagina: se è lento, tutte le metriche successive lo sono. La cache di pagina è lo strumento più efficace per ridurlo, e Varnish, con la sua memoria, la sua logica configurabile e la gestione dei picchi, è la soluzione di riferimento quando il traffico e il valore delle pagine sono alti. Ma la cache funziona davvero solo se è progettata sull’applicazione, con regole di esclusione e di invalidazione precise, e se il percorso senza cache resta comunque rapido.
È un lavoro che unisce sistemistica e sviluppo: per questo lo affrontiamo sempre guardando insieme server e applicazione, e verificando i risultati sui dati degli utenti reali, non su un singolo test.
