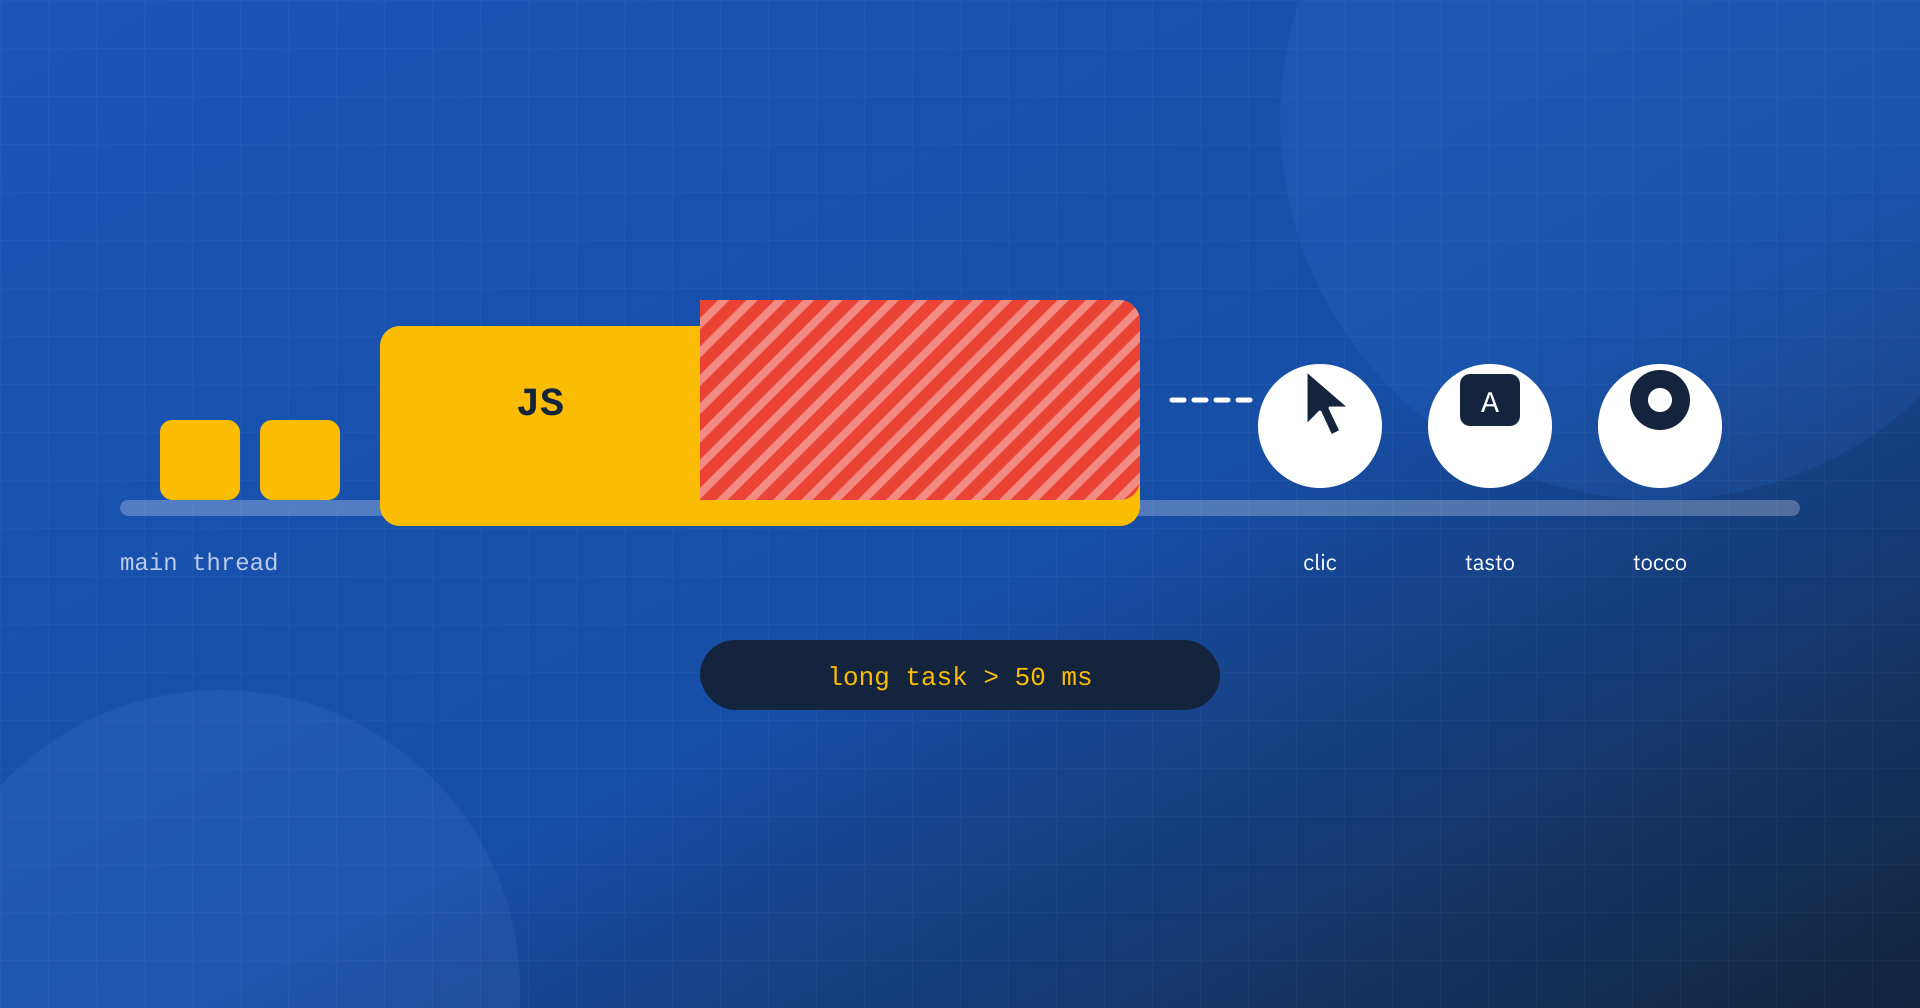
Chi si occupa di Web Performance incontra presto tre termini che tornano in ogni report: main thread, long task e Total Blocking Time. Lighthouse segnala di «ridurre il lavoro del main thread», PageSpeed Insights mostra un TBT in rosso, i DevTools evidenziano blocchi gialli con un triangolino rosso. Sono concetti che sembrano riservati agli sviluppatori front-end, ma spiegano uno dei problemi più comuni e più sottovalutati dei siti moderni: una pagina che sembra caricata, ma non risponde.
In questo articolo proviamo a spiegarli in modo semplice, partendo da come lavora il browser, per arrivare a cosa misurano le metriche, come si individuano i colpevoli e come si interviene.
Il main thread: un solo operaio per quasi tutto
Per mostrare una pagina, il browser deve svolgere molti lavori diversi: leggere l’HTML e costruire il DOM, applicare i fogli di stile, calcolare la posizione e la dimensione di ogni elemento, disegnare, eseguire il JavaScript e rispondere a clic, tocchi e tasti. Alcune attività, come il download delle risorse o la decodifica delle immagini, avvengono in parallelo su altri thread. Ma la maggior parte del lavoro legato alla pagina, e in particolare tutto il JavaScript della pagina e la gestione degli eventi, avviene su un unico thread: il main thread.
Il modo più semplice per immaginarlo è un unico operaio che esegue un compito alla volta, da una coda. Ogni compito, che si chiama task, viene portato a termine prima di passare al successivo: l’operaio non può interromperne uno a metà per occuparsi di qualcosa di più urgente. Se l’utente tocca un pulsante mentre il main thread sta eseguendo uno script, il tocco finisce in coda e verrà gestito solo quando lo script avrà finito. Nel frattempo, la pagina appare immobile: nessuna reazione visiva, nessun cambiamento, a volte nemmeno lo scorrimento se dipende da gestori di eventi in JavaScript.
Che cos’è un long task
Un long task è un task che occupa il main thread per più di 50 millisecondi. La soglia non è arbitraria: deriva dal modello RAIL proposto da Google, secondo cui una risposta entro 100 millisecondi viene percepita come immediata. Se ogni task dura al massimo 50 millisecondi, un’interazione che arriva nel momento peggiore aspetta al massimo 50 millisecondi, e restano altri 50 millisecondi per elaborarla e disegnare il risultato. Oltre questa soglia, la probabilità che l’utente percepisca un ritardo cresce rapidamente.
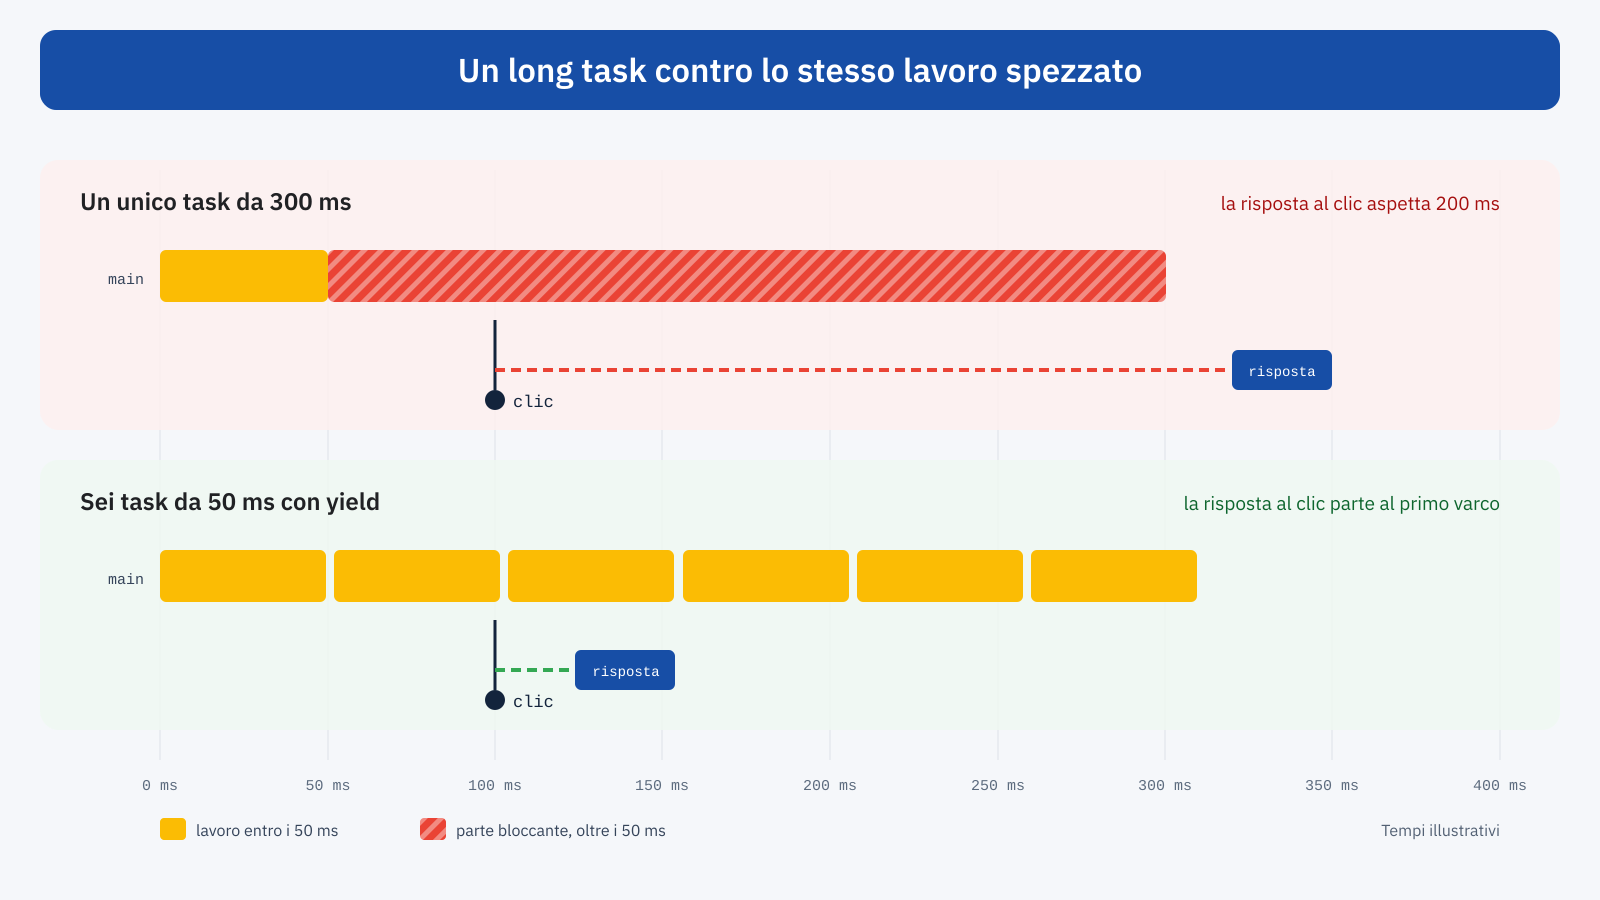
Il problema non è la quantità totale di lavoro, ma la sua distribuzione. Trecento millisecondi di JavaScript eseguiti in un unico blocco lasciano l’utente in attesa per tutta la loro durata; gli stessi trecento millisecondi divisi in sei blocchi da cinquanta, con dei varchi tra l’uno e l’altro, permettono al browser di inserire la risposta a un clic nel primo varco disponibile.
Il Total Blocking Time
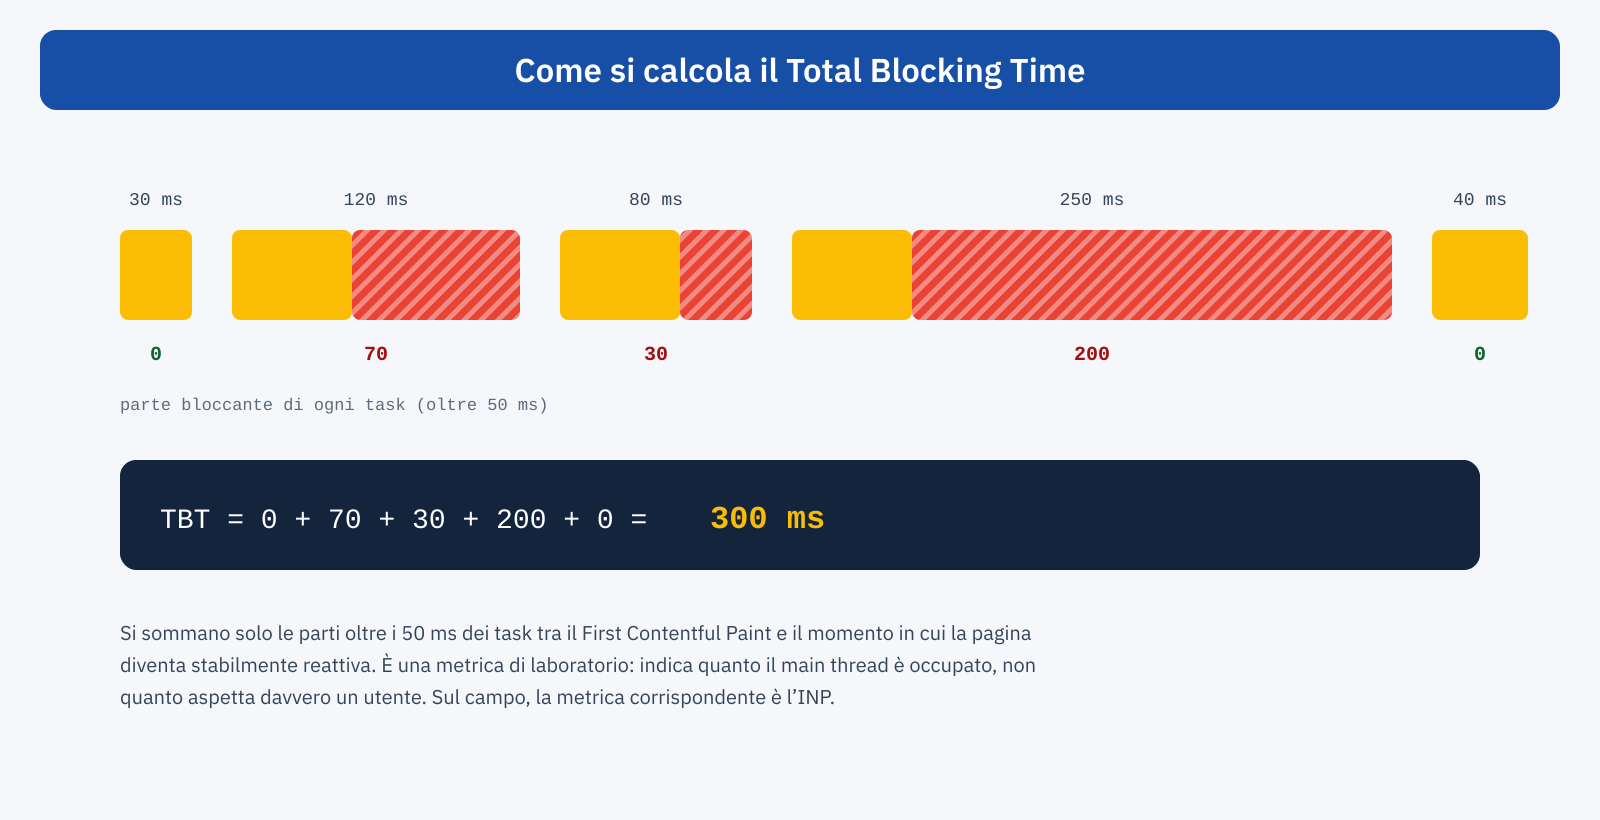
Il Total Blocking Time, o TBT, è la metrica che Lighthouse usa per misurare quanto il main thread è bloccato durante il caricamento. Il calcolo è semplice: per ogni long task che avviene tra il First Contentful Paint e il momento in cui la pagina diventa stabilmente reattiva, si prende la parte che supera i 50 millisecondi, e si sommano tutte queste parti. Un task da 120 millisecondi contribuisce con 70, uno da 40 non contribuisce affatto.
Nel punteggio di Lighthouse il TBT ha un peso importante, il più alto tra le metriche considerate, ed è spesso il motivo principale per cui un sito ottiene un punteggio basso da mobile. Per un sito da desktop un TBT sotto i 200 millisecondi è considerato buono; su mobile, dove Lighthouse simula un processore più lento, raggiungerlo è molto più impegnativo.
Va però ricordato cosa il TBT è e cosa non è. È una metrica di laboratorio: misura quanto il main thread è occupato durante un caricamento simulato, senza che nessuno interagisca con la pagina. Non misura quanto aspetta davvero un utente, perché nel test non ci sono utenti. È un indicatore, utile perché correlato alla reattività reale, ma non è una Core Web Vital e non viene usato da Google per valutare le pagine. La metrica di campo corrispondente è l’INP, che misura il tempo di risposta alle interazioni reali degli utenti reali, come spiegato nell’articolo sulle differenze tra PageSpeed Insights e Lighthouse.
Come i long task colpiscono le Core Web Vitals
Il legame più diretto è con l’INP. Il tempo di risposta a un’interazione si compone di tre parti: il ritardo prima che il gestore dell’evento possa partire, il tempo di esecuzione del gestore e il tempo per disegnare il risultato. I long task incidono su tutte e tre. Un long task in corso al momento del clic allunga il ritardo iniziale; un gestore dell’evento che esegue troppo lavoro è esso stesso un long task; un aggiornamento del DOM che richiede ricalcoli di stile e layout pesanti ritarda il disegno.
Ma anche l’LCP ne risente. Se il main thread è occupato a eseguire script quando l’immagine principale o il testo sono pronti, il browser non può disegnarli finché non si libera. Su pagine con molto JavaScript sincrono nell’intestazione, capita di vedere un LCP che arriva centinaia di millisecondi dopo il download dell’immagine, semplicemente perché il main thread era impegnato altrove.
Da dove arrivano i long task
- Valutazione degli script. Ogni file JavaScript va analizzato, compilato ed eseguito. Pacchetti grandi, con librerie intere caricate per usarne una funzione, producono long task già al caricamento.
- Script di terze parti. Analytics, pixel, chat, test A/B e widget eseguono spesso lavoro pesante proprio durante il caricamento, come abbiamo visto parlando degli script di terze parti.
- Idratazione dei framework. Nei siti costruiti con framework JavaScript, il codice che rende interattiva una pagina generata sul server può occupare il main thread per centinaia di millisecondi.
- Ricalcoli di stile e layout. Un DOM molto grande, o codice che legge e modifica alternativamente le dimensioni degli elementi, costringe il browser a ricalcolare il layout più volte nello stesso task.
- Elaborazione di dati. Analisi di grandi JSON, ordinamenti, filtri su elenchi lunghi eseguiti nel gestore di un evento.
Come individuarli
Il pannello Performance dei DevTools di Chrome è lo strumento principale. Registrando un caricamento o un’interazione, la traccia del main thread mostra ogni task come un blocco; i long task sono segnalati con un triangolo rosso e una parte tratteggiata che corrisponde alla porzione oltre i 50 millisecondi. Espandendo un blocco si vede la catena di chiamate e, soprattutto, il file e la funzione responsabili. Conviene registrare con il rallentamento della CPU attivo, per avvicinarsi alle condizioni di uno smartphone di fascia media.
Sugli utenti reali, Chrome mette a disposizione la Long Animation Frames API, che segnala i fotogrammi in cui il browser ha impiegato più di 50 millisecondi per aggiornare lo schermo e, a differenza della precedente Long Tasks API, indica quali script hanno contribuito, con file, funzione e durata. È lo strumento più utile per scoprire quali script rallentano le interazioni sui dispositivi dei visitatori:
new PerformanceObserver( ( list ) => {
	for ( const frame of list.getEntries() ) {
		for ( const script of frame.scripts ) {
			// File, funzione e durata di ogni script coinvolto
			console.log( script.sourceURL, script.sourceFunctionName, script.duration );
		}
	}
} ).observe( { type: 'long-animation-frame', buffered: true } );
Come intervenire
Eseguire meno codice
Il primo intervento è sempre il più efficace: eliminare il codice che non serve. Script caricati su tutte le pagine ma usati solo su alcune, librerie sostituibili con poche righe di codice nativo, funzionalità dimenticate. Il secondo è rimandare il codice che non serve subito: script non critici caricati con defer, widget avviati solo quando l’utente interagisce, come nella tecnica del delay del JavaScript al primo clic.
Spezzare il lavoro lungo
Quando il lavoro è necessario, si può dividerlo in parti più piccole e restituire periodicamente il controllo al browser, un’operazione che si chiama yield. Tra una parte e l’altra il browser può gestire gli input in coda e aggiornare lo schermo. Nelle versioni recenti di Chrome esiste una funzione dedicata, scheduler.yield(), che restituisce il controllo e poi riprende il lavoro con priorità, prima di altri task meno importanti; negli altri browser si può ricorrere a setTimeout:
function cediIlPasso() {
	if ( globalThis.scheduler?.yield ) {
		return scheduler.yield();
	}
	return new Promise( ( resolve ) => setTimeout( resolve, 0 ) );
}

async function elaboraTutto( elementi ) {
	for ( const elemento of elementi ) {
		elabora( elemento );
		await cediIlPasso(); // lascia rispondere il browser tra un elemento e l’altro
	}
}
Nei gestori degli eventi, il principio è dare subito un riscontro visivo e rimandare il resto. Se un clic deve aggiornare l’interfaccia, inviare un evento di analytics e salvare dati, conviene aggiornare prima l’interfaccia, cedere il passo per permettere al browser di disegnare, e solo dopo eseguire il resto.
Spostare il lavoro altrove
Per le elaborazioni pesanti che non toccano il DOM, come calcoli, analisi di dati o compressione, i Web Worker permettono di eseguire JavaScript su un thread separato, lasciando libero il main thread. Per il lavoro non urgente, requestIdleCallback lo esegue quando il browser non ha altro da fare. E per il rendering, ridurre la dimensione del DOM e usare proprietà come content-visibility diminuisce il costo di ogni ricalcolo di stile e layout.
Perché su mobile è peggio
Uno stesso script può durare 40 millisecondi su un computer recente e 200 su uno smartphone economico. La differenza di potenza tra i processori dei dispositivi più diffusi e quelli usati da chi sviluppa è enorme, e il JavaScript è una delle attività che ne risentono di più. Per questo un sito che sembra perfettamente reattivo in ufficio può avere un INP scarso nei dati di campo: i long task che sul computer dello sviluppatore non esistono compaiono sui telefoni di fascia media, che sono la maggioranza dei visitatori reali.
È anche la ragione per cui Lighthouse, nella modalità mobile, simula un processore rallentato, e per cui il TBT da mobile è quasi sempre molto più alto di quello da desktop. Quando si prova un sito a mano, conviene attivare il rallentamento della CPU nei DevTools, di quattro o sei volte, oppure usare un vero smartphone di fascia media: è il modo più rapido per vedere la pagina come la vede la maggior parte degli utenti.
Il caso WordPress
Sui siti WordPress i long task arrivano raramente dal core, e molto più spesso da ciò che vi si aggiunge: temi e costruttori di pagine che caricano jQuery e decine di script su ogni pagina, slider e animazioni, plugin di statistiche, moduli, cookie e marketing. Il pannello Performance, con i nomi dei file nelle tracce, di solito indica rapidamente quali plugin sono responsabili. Da lì le strade sono le stesse: rimuovere, limitare alle pagine in cui servono, differire.
In sintesi
Il main thread è l’unico operaio che esegue JavaScript, calcola il layout, disegna e risponde agli utenti. Un long task è un compito che lo tiene occupato per più di 50 millisecondi, durante i quali la pagina non può reagire. Il Total Blocking Time somma queste attese durante il caricamento in laboratorio ed è un buon indicatore, ma la metrica che conta sul campo è l’INP.
Per migliorare si segue un ordine preciso: eseguire meno codice, rimandare quello non urgente, spezzare quello lungo cedendo il passo al browser, spostare le elaborazioni pesanti fuori dal main thread. I DevTools e la Long Animation Frames API indicano dove intervenire. Non serve un sito senza JavaScript: serve un JavaScript che lasci sempre al browser un momento per rispondere a chi sta usando la pagina.
