Capita spesso: il sito rallenta, il tempo di risposta del server cresce, il pannello dell’hosting segnala un uso della CPU vicino al limite, ma Google Analytics non mostra alcun aumento di visitatori. Il motivo è che una parte crescente del traffico dei siti non viene da persone. Crawler dei motori di ricerca, crawler che raccolgono contenuti per i modelli di intelligenza artificiale, strumenti di analisi SEO, scraper che copiano prezzi e testi, scansioni automatiche alla ricerca di vulnerabilità: tutti chiedono pagine al server, e molti di loro non compaiono negli strumenti di analisi perché non eseguono JavaScript.
Questo traffico non viene misurato dalle Core Web Vitals, che raccolgono solo i dati degli utenti reali. Ma le influenza, perché consuma le stesse risorse che servono a rispondere agli utenti. In questo articolo vediamo come riconoscerlo, perché pesa più di quanto il numero di richieste farebbe pensare, e come filtrarlo senza danneggiare il posizionamento o i servizi legittimi.
Chi sono i visitatori automatici
Non tutto il traffico automatico è indesiderato, e distinguere le categorie è il primo passo per decidere cosa fare:
- crawler dei motori di ricerca, come Googlebot e Bingbot: indispensabili per il posizionamento, di solito ben educati, rispettano le indicazioni del file robots.txt e adattano la frequenza alla capacità del server;
- crawler per l’intelligenza artificiale: raccolgono contenuti per addestrare modelli o per rispondere alle domande degli utenti. Alcuni si identificano e rispettano robots.txt, altri no; alcuni scaricano grandi quantità di pagine in poco tempo;
- strumenti SEO e di monitoraggio: servizi che analizzano collegamenti, posizionamento e contenuti per conto dei loro clienti, spesso per siti concorrenti;
- scraper: programmi che copiano prezzi, schede prodotto o articoli, spesso con identità false per non essere riconosciuti;
- scansioni e attacchi: richieste automatiche che cercano pagine di accesso, file di configurazione esposti, vulnerabilità di plugin noti, o tentano password su
wp-login.phpexmlrpc.php; - servizi legittimi: monitoraggio della disponibilità, lettori di feed, anteprime dei collegamenti sui social network, notifiche dei sistemi di pagamento. Poche richieste, ma che non vanno bloccate.
Perché pesano più delle richieste che fanno
Un sito ben configurato serve la maggior parte delle pagine agli utenti dalla cache di pagina: la home, gli articoli recenti, le categorie principali. Le persone tendono a visitare le stesse pagine, e quelle pagine sono quasi sempre già pronte. I bot si comportano diversamente. Un crawler che vuole leggere tutto il sito chiede anche gli articoli di dieci anni fa, le pagine di archivio numero 200, le combinazioni di filtri di un negozio, i risultati di ricerca interni. Sono pagine che la cache non contiene, e che quindi richiedono di eseguire PHP e interrogare il database.
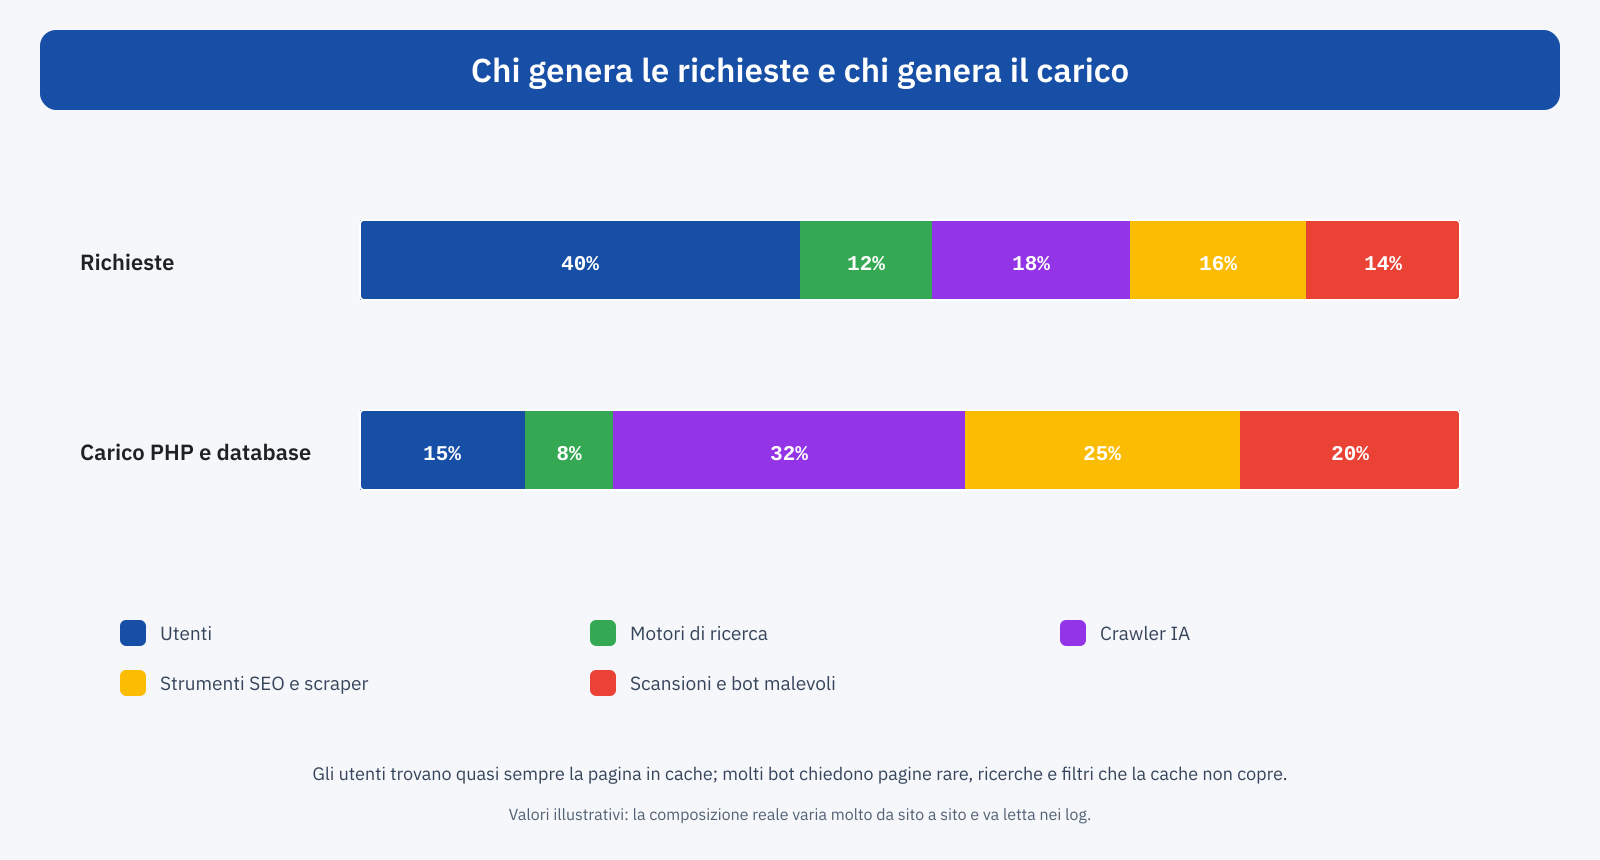
Il risultato è che i bot, anche quando generano una quota minoritaria delle richieste, possono generare la maggior parte del lavoro del server. Nei negozi online il problema è amplificato dalla navigazione a faccette: ogni combinazione di filtri, ordinamenti e pagine è un indirizzo diverso, e un crawler che segue tutti i collegamenti può generare milioni di richieste, ciascuna delle quali esegue interrogazioni costose, come abbiamo visto parlando di WooCommerce e del database di WordPress.
Quando il server è occupato a rispondere ai bot, le richieste degli utenti aspettano in coda. Il TTFB cresce, e con esso l’LCP. Le richieste dinamiche degli utenti, come il carrello, il pagamento, l’area riservata, sono le più colpite, perché non possono essere servite dalla cache. È lo stesso meccanismo descritto a proposito dei picchi di traffico, con la differenza che il picco non porta clienti.
Riconoscerli: i log del server
Gli strumenti di analisi basati su JavaScript, come abbiamo visto parlando di analytics, vedono solo i visitatori che eseguono gli script, cioè quasi esclusivamente le persone. Per vedere i bot bisogna guardare i log di accesso del server web o della CDN, che registrano ogni richiesta con indirizzo IP, data, indirizzo richiesto, codice di risposta, dimensione e user agent. Anche senza strumenti dedicati, pochi comandi danno un quadro chiaro:
# I 20 user agent con più richieste
awk -F'"' '{print $6}' access.log | sort | uniq -c | sort -rn | head -20

# I 20 indirizzi IP con più richieste
awk '{print $1}' access.log | sort | uniq -c | sort -rn | head -20

# Le richieste di ricerca interna e di filtri
grep -cE '\?s=|filter_|orderby=' access.log
Se il server registra anche il tempo di elaborazione di ogni richiesta, si può andare oltre il conteggio e sommare il tempo per user agent o per indirizzo: è il dato che dice davvero chi consuma le risorse. Molti pannelli di hosting e molte CDN offrono statistiche già aggregate, con la distinzione tra traffico umano e automatico. Per Googlebot, il rapporto sulle statistiche di scansione di Search Console mostra il numero di richieste al giorno e il tempo medio di risposta visto dal crawler.
Una cautela: lo user agent è dichiarato da chi fa la richiesta e può essere falso. Molti scraper si presentano come Googlebot o come un normale browser. Per verificare che una richiesta venga davvero da Google si usa una ricerca DNS inversa sull’indirizzo IP, che deve restituire un nome nei domini di Google, seguita da una ricerca diretta di conferma; in alternativa, Google e gli altri principali motori pubblicano gli intervalli di indirizzi dei loro crawler.
Robots.txt: utile ma volontario
Il file robots.txt indica ai crawler quali parti del sito non visitare. È il primo strumento da usare, perché i crawler legittimi lo rispettano e non ha costi: escludere i risultati di ricerca interna, le combinazioni di filtri, le pagine del carrello e dell’account riduce subito le richieste inutili dei motori di ricerca e dei crawler ben educati.
User-agent: *
Disallow: /?s=
Disallow: /*?*filter_
Disallow: /*?*orderby=
Disallow: /carrello/
Disallow: /mio-account/

# Crawler IA che non si desidera far accedere
User-agent: GPTBot
User-agent: CCBot
Disallow: /
Il limite è che robots.txt è una richiesta, non un blocco: i bot che non lo rispettano, o che si presentano con un’identità falsa, lo ignorano. Inoltre alcune indicazioni non sono supportate da tutti: la direttiva Crawl-delay, per esempio, è rispettata da alcuni motori ma non da Google, che regola la frequenza in base alla risposta del server. Sulla scelta di bloccare o meno i crawler dell’intelligenza artificiale non esiste una risposta unica: dipende da quanto il sito tiene alla visibilità nelle risposte degli assistenti e da quanto quel traffico pesa. Quello che conta è che sia una scelta consapevole, basata sui dati dei log. Bloccare Googlebot o Bingbot, invece, ha effetti diretti sul posizionamento e va evitato.
Filtrare prima dell’origine
Il principio più importante è fermare le richieste indesiderate il più lontano possibile da PHP e dal database. Una richiesta bloccata dalla CDN non costa nulla al server; una bloccata da un plugin di sicurezza di WordPress costa quasi quanto servirla, perché per arrivare al plugin WordPress deve comunque avviarsi.
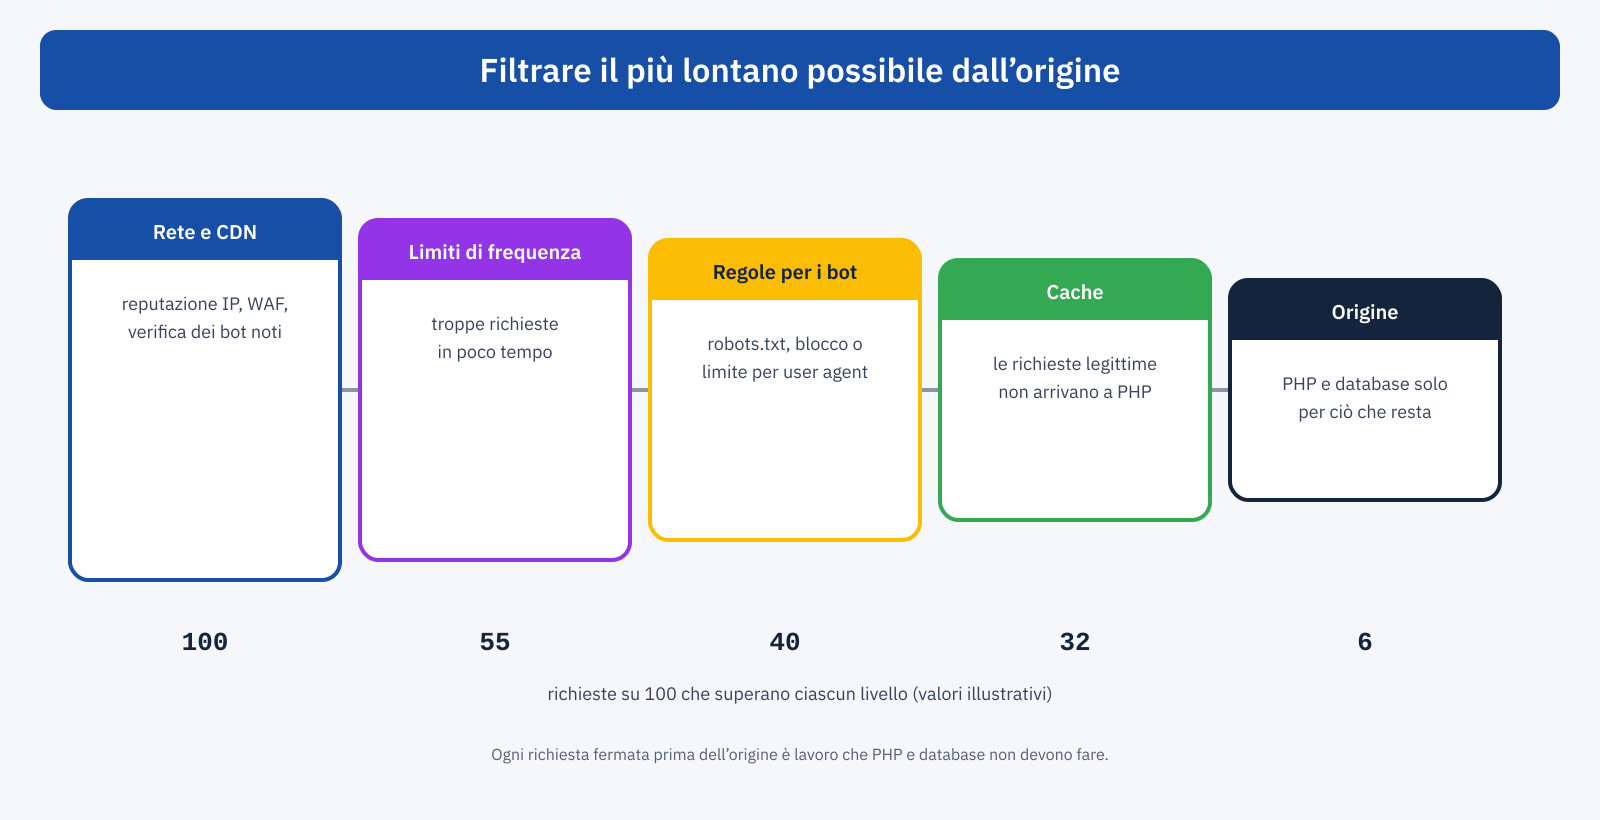
I livelli di difesa, dal più esterno al più interno, sono questi:
- CDN e firewall applicativo (WAF): bloccano le richieste da indirizzi con cattiva reputazione, i tentativi di attacco noti, e molti offrono la verifica dei crawler legittimi e regole specifiche per i crawler dell’intelligenza artificiale. Come discusso nell’articolo su Cloudflare, non sono una soluzione universale, ma per questo compito sono lo strumento più efficace;
- limiti di frequenza: un numero massimo di richieste per indirizzo in un intervallo di tempo, applicato dalla CDN o dal server web, ferma i bot più aggressivi senza toccare le persone, che non chiedono decine di pagine al secondo;
- regole per user agent e percorsi: blocchi mirati per i bot che non rispettano robots.txt, e protezione dei percorsi sensibili come
wp-login.phpexmlrpc.php, quest’ultimo da disattivare se non usato; - cache: servire dalla cache anche le richieste dei bot legittimi, evitando che parametri inutili, come quelli di tracciamento o parametri casuali, generino versioni diverse della stessa pagina;
- origine: all’applicazione arrivano solo le richieste che devono davvero essere elaborate.
A livello di server web, un limite di frequenza si configura con poche righe. Un esempio per Nginx, che limita a due richieste al secondo per indirizzo le ricerche interne, con una piccola tolleranza per i picchi:
# Nel blocco http: la chiave è vuota (quindi senza limite) se non è una ricerca
map $arg_s $chiave_ricerca {
	""      "";
	default $binary_remote_addr;
}
limit_req_zone $chiave_ricerca zone=ricerca:10m rate=2r/s;

# Nel blocco server
server {
	# ...
	limit_req zone=ricerca burst=5 nodelay;
	limit_req_status 429;
}
La configurazione esatta dipende dal server e dall’hosting, e va provata con attenzione: un limite troppo stretto può bloccare utenti reali che condividono lo stesso indirizzo, come i dipendenti di un’azienda o i clienti di un operatore mobile.
Ridurre ciò che i bot possono chiedere
Oltre a filtrare, conviene ridurre la superficie che i bot possono esplorare. Le combinazioni di filtri di un negozio possono usare collegamenti che i crawler non seguono, o parametri esclusi da robots.txt; le pagine di ricerca interna possono essere escluse dall’indicizzazione; i tag e gli archivi poco utili possono essere eliminati. Le risposte di errore, come le pagine non trovate, dovrebbero essere leggere e, dove possibile, messe in cache per un breve periodo: le scansioni generano migliaia di richieste a indirizzi inesistenti, e in molte installazioni ognuna esegue WordPress per intero.
Un altro punto riguarda wp-cron, che in WordPress viene attivato dalle visite: con molto traffico automatico viene eseguito continuamente. Sostituirlo con un’operazione pianificata del sistema, a intervalli regolari, elimina un carico inutile. Infine, un object cache persistente riduce il costo delle richieste che arrivano comunque all’origine.
Cosa non bloccare
Il rischio opposto è bloccare troppo. Oltre ai motori di ricerca, vanno lasciati passare i servizi di cui il sito ha bisogno: le notifiche dei sistemi di pagamento, i servizi di monitoraggio, i lettori di feed, i sistemi che generano le anteprime dei collegamenti sui social network e nelle app di messaggistica, le integrazioni con gestionali e marketplace. Prima di attivare un blocco generalizzato, come una verifica obbligatoria per tutto il traffico non riconosciuto, conviene verificare nei log quali servizi legittimi accedono al sito e prevedere le eccezioni. Ogni modifica va poi monitorata per qualche giorno, controllando gli errori nei log e nel rapporto di scansione di Search Console.
Un esempio concreto
Un negozio online con circa duemila prodotti nota che il TTFB delle pagine di categoria, nei dati reali, è raddoppiato nell’arco di qualche settimana, senza modifiche al sito e senza aumenti di visite in analytics. I log mostrano che oltre metà delle richieste arriva da pochi crawler che esplorano tutte le combinazioni di filtri, e che una parte di loro si presenta come un normale browser ma proviene da pochi intervalli di indirizzi di fornitori cloud. L’intervento consiste nell’escludere i parametri dei filtri in robots.txt, nell’attivare nella CDN la verifica dei crawler noti e un limite di frequenza per indirizzo sulle pagine con filtri, e nel bloccare gli intervalli di indirizzi da cui arriva lo scraping. Il carico del server si riduce drasticamente, e il TTFB degli utenti torna ai valori precedenti, senza cambiare una riga del tema.
In sintesi
Una parte importante del lavoro dei server è fatta per visitatori che non sono persone. I bot chiedono spesso pagine che la cache non copre, e per questo pesano sul server più di quanto dica il numero delle loro richieste; quando il server è saturo, a pagare sono gli utenti reali, con un TTFB e un LCP peggiori. Per affrontare il problema servono i log del server, perché gli strumenti di analisi non vedono i bot; serve distinguere i crawler utili da quelli indesiderati, verificando le identità dichiarate; e servono difese a più livelli, il più possibile lontane dall’origine: robots.txt, CDN e WAF, limiti di frequenza, cache efficace anche per i bot. Senza dimenticare di lasciare aperta la porta ai servizi di cui il sito ha bisogno.