Ogni sito ha i suoi giorni decisivi. Per un negozio online sono il Black Friday, i saldi, il periodo natalizio. Per un’azienda possono essere il lancio di un prodotto, un passaggio televisivo, una campagna pubblicitaria, l’invio di una newsletter a centomila iscritti. In quei momenti arriva in poche ore il traffico di settimane, e arriva proprio quando ogni visita vale di più. È anche il momento in cui molti siti rallentano, rispondono con errori o smettono del tutto di funzionare.
Le prestazioni sotto carico sono un aspetto delle Web Performance che i test abituali non misurano: PageSpeed Insights e Lighthouse caricano una pagina alla volta, in condizioni tranquille. In questo articolo vediamo cosa succede a un sito quando il traffico si moltiplica, come stimare quanto può reggere, come verificarlo con un test di carico e come prepararlo ai picchi.
Cosa succede quando il traffico cresce
Per capire come si comporta un sito sotto carico bisogna distinguere due tipi di richieste. Le pagine servite dalla cache di pagina, come la home, le categorie e le schede prodotto per i visitatori anonimi, richiedono pochissime risorse: il server web restituisce un file già pronto, e un server moderno può farlo migliaia di volte al secondo. Le pagine dinamiche, come carrello, checkout, area riservata, ricerca e le chiamate AJAX, devono invece essere generate da PHP e dal database a ogni richiesta.
Le richieste dinamiche vengono elaborate da un numero limitato di processi PHP, spesso chiamati PHP worker. Ogni processo gestisce una richiesta alla volta: se un sito ha otto processi e ogni richiesta dinamica impiega 400 millisecondi, può elaborarne al massimo una ventina al secondo. Quando ne arrivano di più, le richieste in eccesso aspettano in coda. Il tempo passato in coda si aggiunge al tempo di risposta, e quindi al TTFB che l’utente sperimenta.
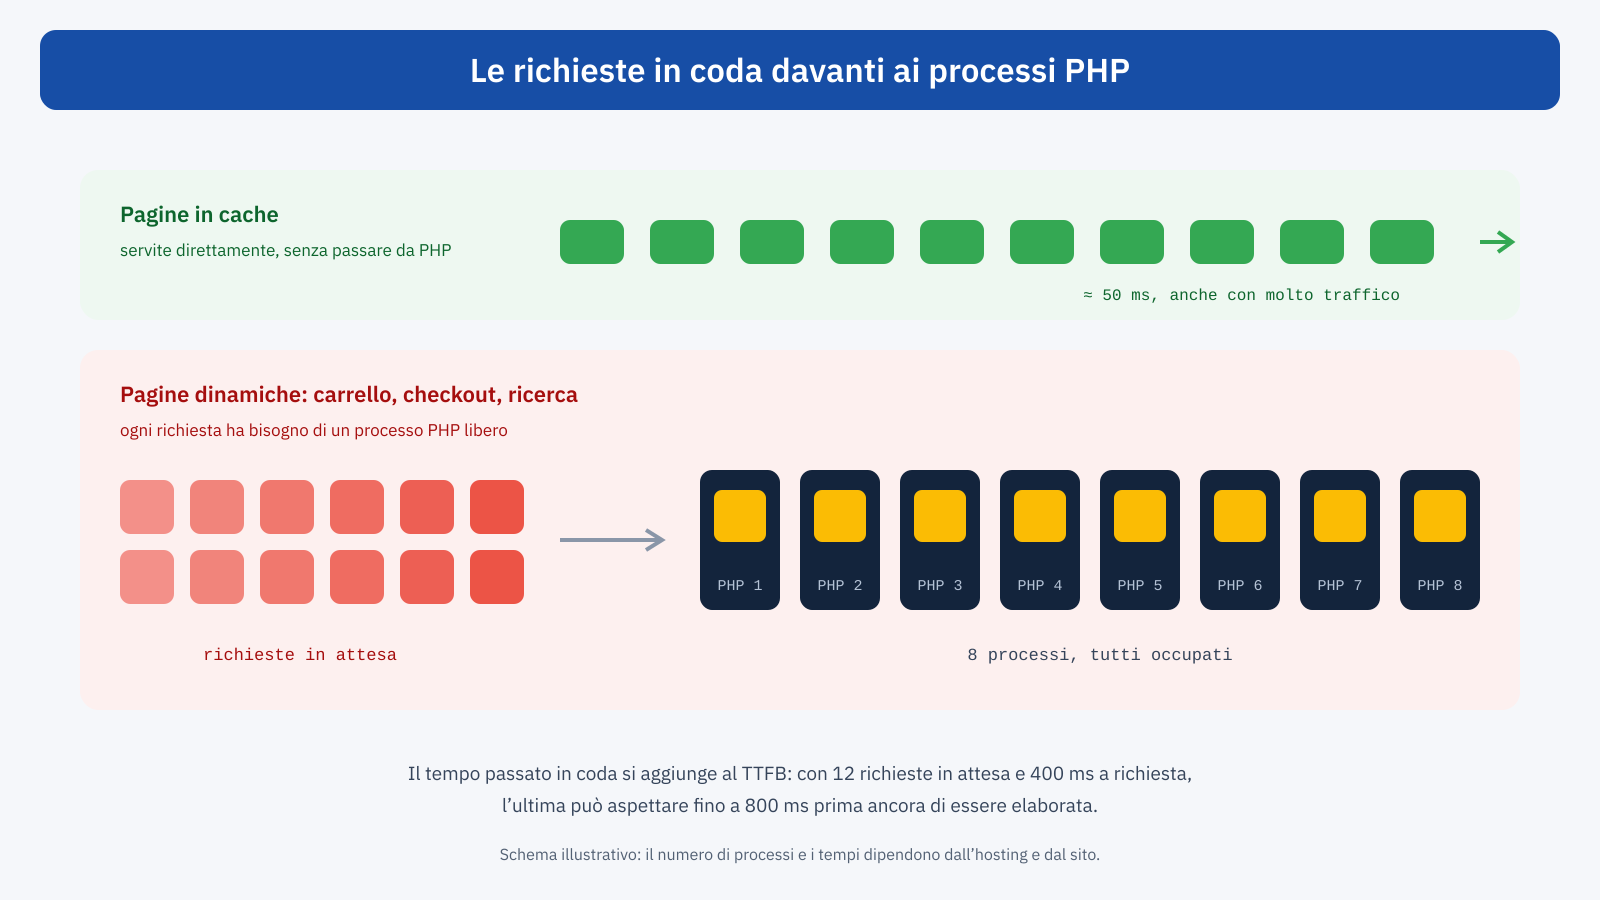
Il comportamento è fortemente non lineare. Finché le richieste arrivano più lentamente di quanto il server riesca a elaborarle, i tempi restano stabili. Appena il ritmo le supera, la coda cresce ogni secondo, i tempi aumentano rapidamente e, oltre un certo punto, le richieste scadono e il server risponde con errori, come i codici 502 o 504. A peggiorare le cose, le richieste lente occupano i processi più a lungo e utenti impazienti ricaricano la pagina, aggiungendo altre richieste alla coda.
Il risultato, per le metriche, è un TTFB che esplode proprio sulle pagine del percorso d’acquisto. Nei dati di campo del Chrome UX Report, mediati su 28 giorni, un picco di un giorno si vede poco. Ma l’effetto economico è concentrato in quelle ore: carrelli abbandonati, pagamenti non completati, clienti che vanno dalla concorrenza, come abbiamo visto nell’articolo sulle Core Web Vitals per WooCommerce.
Stimare la capacità
Una prima stima della capacità di un sito si può fare con un calcolo semplice: numero di processi PHP diviso per il tempo medio di elaborazione di una richiesta dinamica, in secondi, dà il numero massimo di richieste dinamiche al secondo. Con 8 processi e 0,4 secondi a richiesta, il limite è di 20 richieste al secondo. Poi bisogna stimare quante richieste dinamiche genera un utente: una visita al carrello può produrne diverse, tra la pagina, le chiamate AJAX per aggiornare quantità e spedizioni, il mini carrello nell’intestazione, eventuali richieste periodiche del plugin di chat o della bacheca di WordPress.
Il calcolo è approssimativo, ma mostra subito le due leve principali per aumentare la capacità: più processi, cioè più risorse sul server, oppure richieste più rapide, cioè codice e database più efficienti. Dimezzare il tempo di elaborazione di una richiesta equivale a raddoppiare i processi, e spesso costa molto meno.
Il test di carico
La stima va verificata con un test di carico: uno strumento che simula molti utenti contemporanei e misura i tempi di risposta e gli errori al crescere del traffico. Esistono strumenti open source, come k6, Locust e JMeter, e servizi che eseguono i test da server distribuiti. Un test utile ha alcune caratteristiche precise.
- Un ambiente rappresentativo. Idealmente una copia del sito di produzione, sulla stessa infrastruttura, con dati realistici. Testare direttamente la produzione è possibile, ma va fatto in orari di basso traffico e con cautela, avvisando il fornitore di hosting.
- Scenari realistici. Non solo la home ripetuta migliaia di volte, che misura soprattutto la cache, ma percorsi tipici: navigazione tra categorie e prodotti, aggiunta al carrello, ricerca, avvio del checkout, nelle proporzioni osservate negli analytics.
- Carico crescente. Gli utenti simulati aumentano gradualmente, per individuare il punto in cui i tempi smettono di essere stabili.
- Le metriche giuste. Tempo di risposta al 95° percentile, non solo la media, e percentuale di errori, osservati insieme all’utilizzo di processore, memoria e database sul server.
// Scenario k6: navigazione e carrello con carico crescente
import http from 'k6/http';
import { sleep, check } from 'k6';

export const options = {
	stages: [
		{ duration: '2m', target: 100 },
		{ duration: '4m', target: 300 },
		{ duration: '4m', target: 500 },
	],
	thresholds: {
		http_req_duration: [ 'p(95)<800' ],
		http_req_failed: [ 'rate<0.01' ],
	},
};

export default function () {
	http.get( 'https://staging.esempio.it/categoria/scarpe/' );
	sleep( 2 );
	http.get( 'https://staging.esempio.it/prodotto/scarpa-trail/' );
	sleep( 3 );
	const r = http.post( 'https://staging.esempio.it/?wc-ajax=add_to_cart', { product_id: 128, quantity: 1 } );
	check( r, { 'aggiunto al carrello': ( res ) => res.status === 200 } );
	http.get( 'https://staging.esempio.it/carrello/' );
	sleep( 4 );
}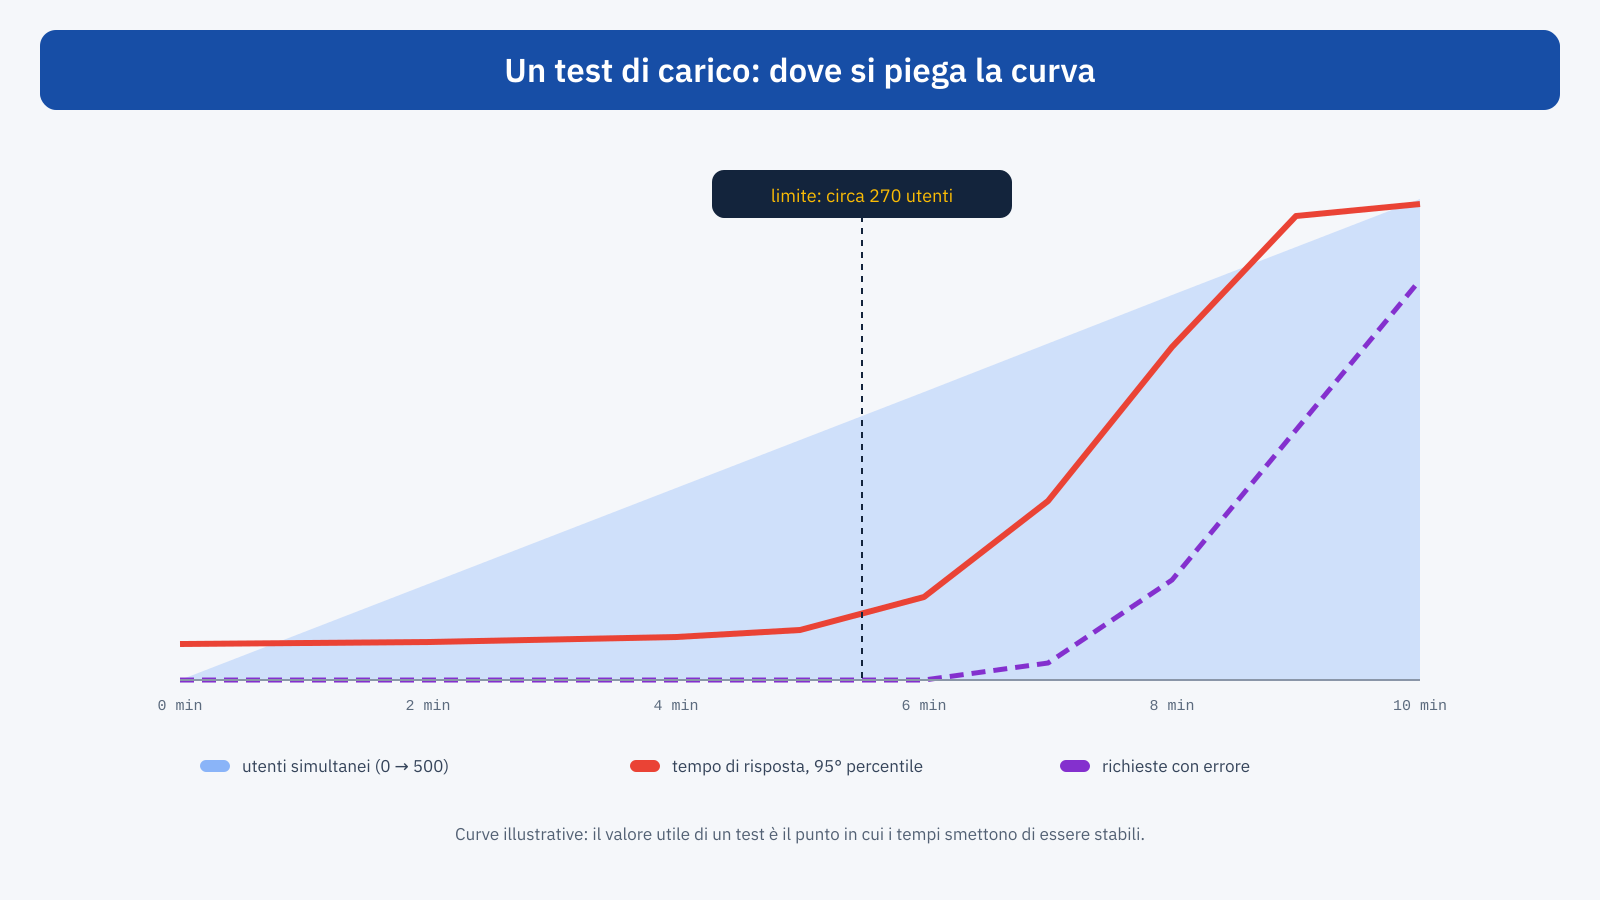
Il risultato da cercare è il punto di rottura: il numero di utenti oltre il quale i tempi smettono di essere stabili. Confrontato con il traffico atteso nel picco, dice se il sito è pronto e con quale margine. Ripetuto dopo ogni intervento, misura l’effetto delle ottimizzazioni. Conviene anche osservare quale risorsa si esaurisce per prima: processi PHP, processore, memoria, connessioni al database. È lì che va concentrato il lavoro.
Preparare il sito: ridurre il lavoro dinamico
La strategia più efficace per reggere un picco è far sì che la maggior parte delle richieste non arrivi a PHP. Alcune misure hanno un impatto enorme.
- Massimizzare la cache di pagina. Verificare che tutte le pagine che possono esserlo siano in cache, anche per chi ha prodotti nel carrello quando la configurazione lo permette, e preriscaldare la cache prima del picco visitando le pagine principali, in modo che i primi visitatori non trovino una cache vuota.
- Eliminare le richieste superflue. Le chiamate AJAX che partono a ogni pagina, come i frammenti del carrello, il battito cardiaco della bacheca di WordPress, contatori e widget che interrogano il server periodicamente, moltiplicano il carico per il numero di visitatori. Ognuna va giustificata o eliminata.
- Rendere più rapide le richieste dinamiche. Una cache degli oggetti riduce le query al database; un’analisi delle query più lente, degli indici mancanti e dei plugin più pesanti accorcia il tempo di elaborazione di ogni richiesta.
- Spostare il lavoro fuori dal momento critico. Invio delle e-mail di conferma in una coda, operazioni pianificate pesanti come importazioni, sincronizzazioni e generazione di report sospese durante il picco, cron di WordPress eseguito dal sistema invece che dalle visite.
- Delegare i contenuti statici. Immagini, fogli di stile e script serviti da una CDN non occupano il server d’origine.
Preparare l’infrastruttura
Ottimizzato il sito, resta la capacità del server. Molti hosting permettono di aumentare temporaneamente le risorse, processi PHP, processore e memoria, per il periodo del picco: va chiesto con anticipo, non la mattina del Black Friday. Le infrastrutture cloud possono scalare automaticamente, ma la scalabilità va configurata e verificata con un test, perché l’avvio di nuove istanze richiede tempo e il database resta spesso un punto unico di contesa. Il confronto tra i modelli di hosting è nell’articolo dedicato a hosting e Core Web Vitals.
Per i picchi estremi e imprevedibili, come un passaggio televisivo, esiste anche la soluzione della sala d’attesa virtuale: quando il traffico supera la capacità, i nuovi visitatori vengono messi in coda su una pagina statica e fatti entrare gradualmente. Non è elegante, ma è molto meglio di un sito che smette di rispondere per tutti.
Un esempio di preparazione
Un negozio di abbigliamento prevede per il Black Friday un traffico otto volte superiore alla media, con una newsletter inviata alle nove del mattino. Il test di carico sull’ambiente di prova mostra il punto di rottura intorno ai 150 utenti simultanei, contro i 600 attesi nel picco. L’analisi indica che metà delle richieste dinamiche sono chiamate AJAX del mini carrello e di un widget di notifiche di acquisto, e che le pagine del carrello impiegano 900 millisecondi a causa di un plugin di calcolo delle spedizioni che interroga un servizio esterno a ogni caricamento.
Il piano prevede di eliminare il widget di notifiche, sostituire il mini carrello con una versione che non interroga il server a ogni pagina, memorizzare per qualche minuto i risultati del calcolo delle spedizioni, attivare la cache degli oggetti e raddoppiare temporaneamente i processi PHP con l’hosting. Il nuovo test porta il punto di rottura oltre i 700 utenti. Il giorno del Black Friday il TTFB del carrello resta sotto i 500 millisecondi anche nell’ora di punta, e il monitoraggio non registra errori.
Il giorno del picco
Alcune regole di comportamento riducono il rischio nelle ore critiche. Nessun rilascio, nessun aggiornamento di plugin e nessuna modifica di configurazione nei giorni immediatamente precedenti e durante il picco: ogni cambiamento introduce un rischio, e il momento peggiore per scoprire un problema è quando il sito è sotto il carico massimo. Un monitoraggio attivo, con avvisi su tempi di risposta, errori e utilizzo delle risorse, permette di intervenire prima che gli utenti se ne accorgano. E un piano di emergenza scritto, con chi fa cosa, quali funzioni disattivare per prime e come contattare l’hosting, evita decisioni improvvisate.
Tra le funzioni da poter disattivare rapidamente in caso di sovraccarico ci sono quelle costose e non essenziali: ricerca con suggerimenti in tempo reale, filtri avanzati del catalogo, prodotti consigliati calcolati al volo, chat, widget di terze parti. Prevedere in anticipo come spegnerle, magari con un’impostazione nel pannello, permette di proteggere il percorso d’acquisto quando serve.
Dopo il picco
Il giorno successivo è il momento migliore per imparare. I log del server e dell’hosting mostrano i picchi di richieste, i tempi di risposta e gli eventuali errori; gli analytics mostrano dove gli utenti hanno abbandonato; un sistema di Real User Monitoring mostra come si sono comportate le metriche ora per ora. Confrontare questi dati con i risultati del test di carico dice se il test era realistico e dove intervenire prima del prossimo evento.
In sintesi
Sotto carico, un sito si comporta in modo diverso da come appare nei test abituali. Le pagine in cache reggono quasi qualsiasi traffico; le richieste dinamiche si mettono in coda davanti a un numero limitato di processi PHP, e oltre un certo punto i tempi esplodono e compaiono gli errori, proprio sulle pagine del percorso d’acquisto e proprio nei momenti in cui ogni visita vale di più.
Prepararsi significa stimare la capacità, verificarla con un test di carico realistico, ridurre il lavoro dinamico con cache, eliminazione delle richieste superflue e ottimizzazione delle query, aumentare temporaneamente le risorse quando serve e affrontare il giorno del picco con monitoraggio, nessun cambiamento e un piano di emergenza. È un lavoro che si fa settimane prima, e che si ripaga in poche ore.