Caro Sean Giuseppe Semeraro, fondatore e sistemista di Iweblab Srl, ci spieghi una cosa? Nel gruppo Facebook WordPress Italia hai pubblicato un post dal titolo «A voler fare gli sboroni con il PageSpeed a 100», per spiegare a tutti che i bei numeri del TTFB «dicono quasi niente» e che l’unica cosa che conta è il verde su CrUX. Bene. Allora ci spieghi perché il tuo sito, che usa la tua «rete Edge», cioè la soluzione di cache che vendi ai clienti, in Europa risponde con un TTFB più lento del 70% rispetto al nostro, a Milano più del doppio, e nella media mondiale del 26%?
Premessa: il nostro sito, managedserver.it, non usa alcuna CDN, né proprietaria né commerciale.
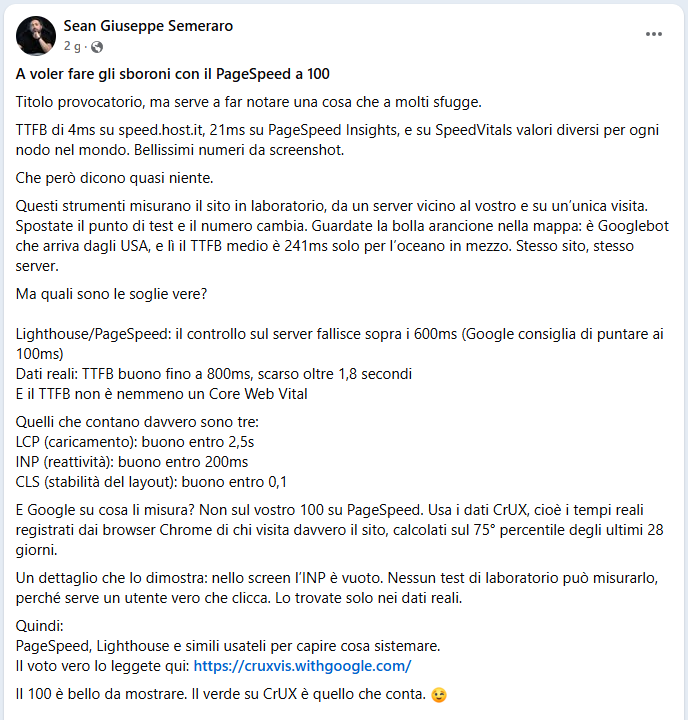
Raccogliamo la provocazione perché quel post, oltre ai numeri, contiene un’idea sbagliata che circola molto tra sistemisti e sviluppatori: che le prestazioni di un sito si giochino tutte sul server, e che basti guardare un dato, il CrUX, per sapere se un lavoro è fatto bene. Ci arriviamo. Prima, i numeri.
I numeri: stesso strumento, stessa metrica
Il primo report è quello che il post stesso allega: SpeedVitals su iweblab.sm, il 22 ottobre. Il secondo è managedserver.it, con lo stesso strumento, il 24 ottobre.
| TTFB (SpeedVitals) | iweblab.sm, con «rete Edge» | managedserver.it, senza CDN |
|---|---|---|
| Europa | 194 ms | 114 ms |
| Milano | 81 ms | 38 ms |
| Francoforte | 86 ms | 71 ms |
| America | 620 ms | 534 ms |
| Media mondiale | 407 ms | 324 ms |
| Cache hit rate | non rilevato | 100% |
| Voto | C | B |
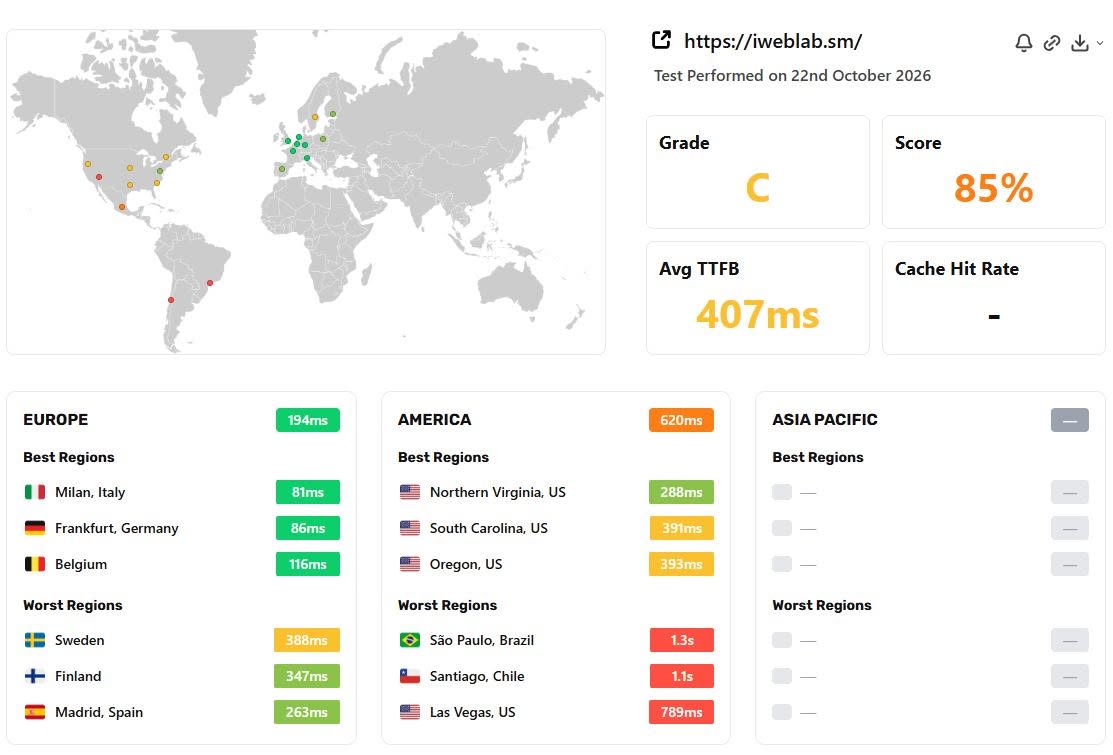
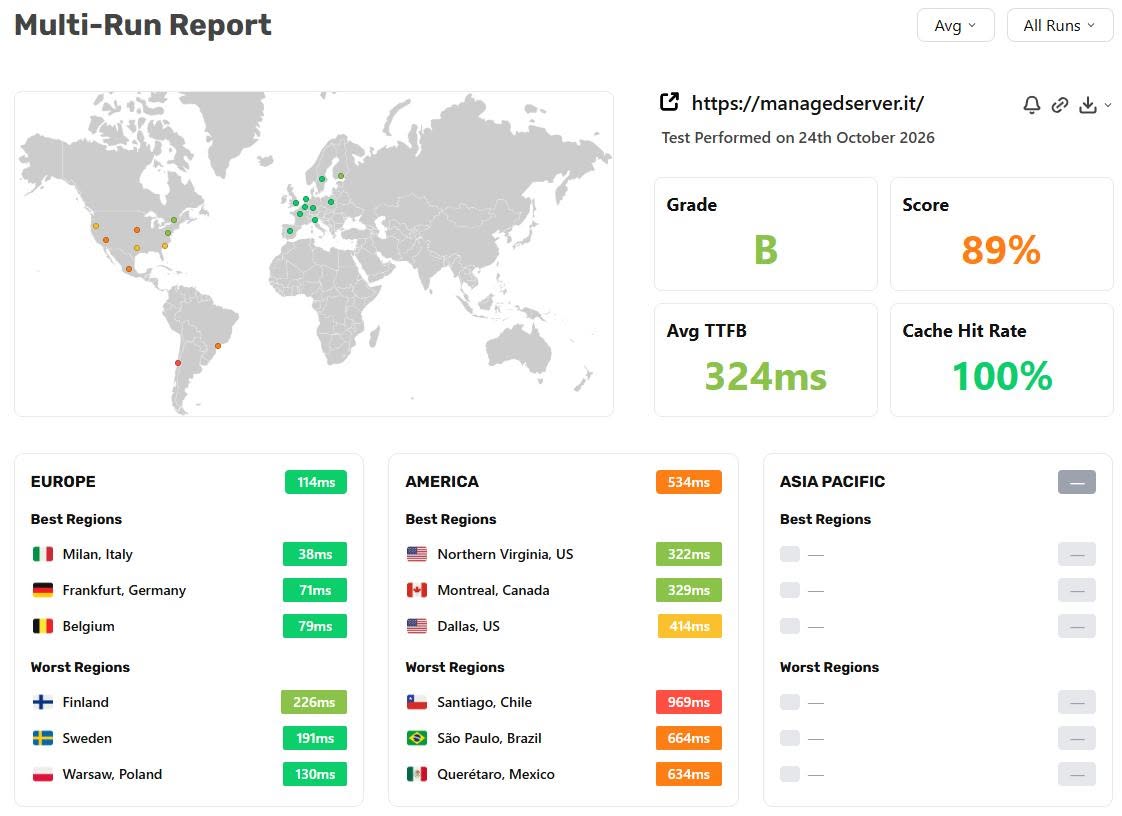
Un sito senza CDN che in Europa risponde quasi il doppio più in fretta di un sito servito da una rete che, sul tuo sito, «tiene in cache le pagine sui suoi nodi e le consegna da vicino». Qualcosa non torna. E non è colpa del laboratorio.
Una «rete Edge» che non consegna da vicino
Forse il motivo è che la tua CDN fatta in casa smista il traffico con il GeoDNS invece che con l’anycast, e non funziona come dovrebbe. Lo si vede dal test di Uptrends: a seconda della località, iweblab.sm si risolve in indirizzi IP diversi. 95.110.225.107, una rete di Aruba, da Milano, Roma, Palermo e perfino da Lille. 81.31.156.7, una rete intestata a Iweblab, da Francoforte, Salisburgo, Praga, Amsterdam, Lipsia ed Eindhoven. 40.160.20.191, una rete di OVH negli Stati Uniti, da Montreal e New York. Con l’anycast l’indirizzo sarebbe lo stesso ovunque e a scegliere il nodo più vicino sarebbe la rete. Qui lo decide il DNS, con tutti i limiti che comporta.
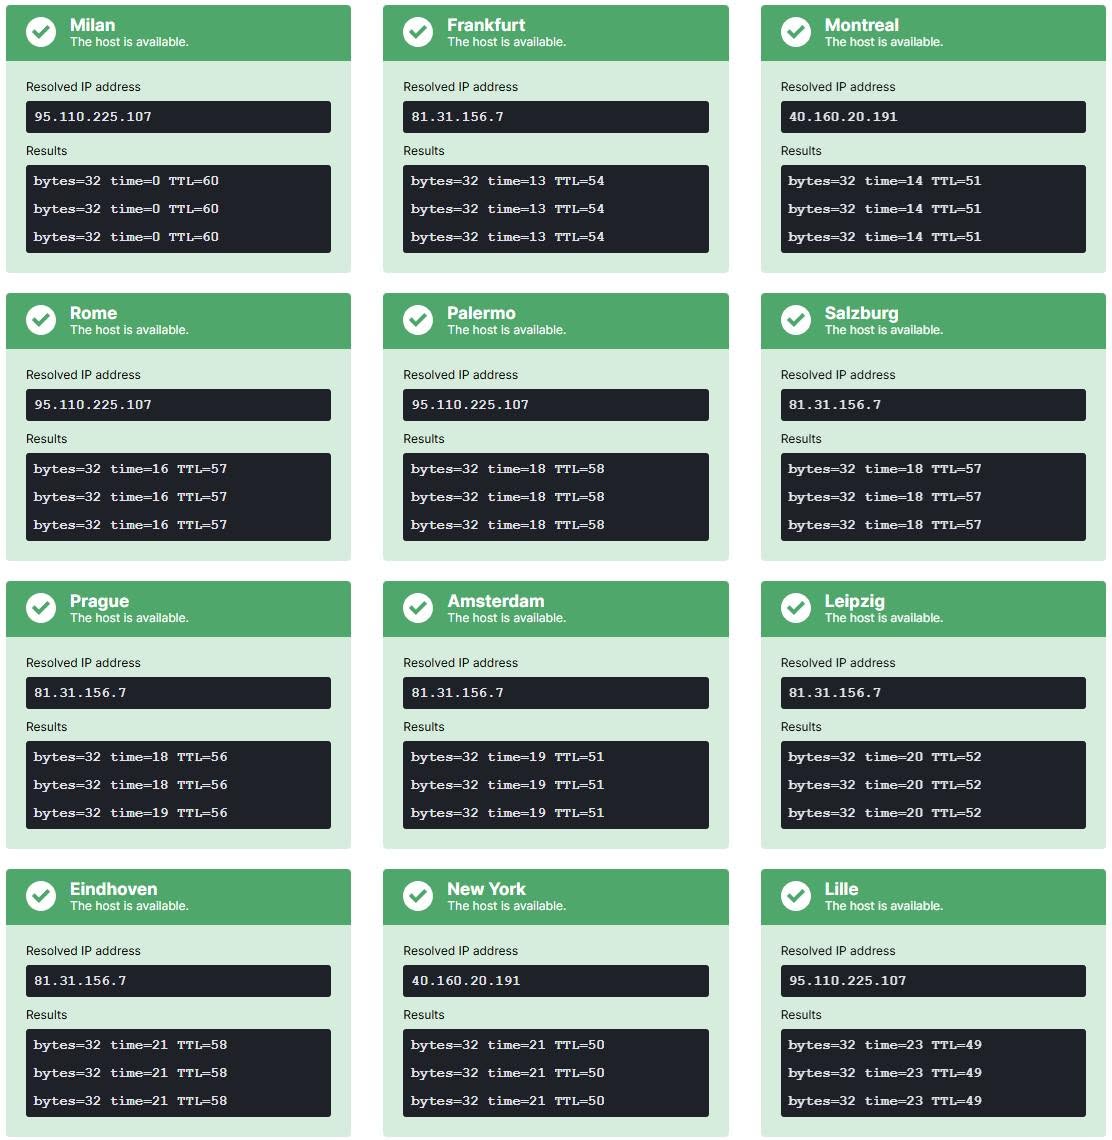
C’è un dettaglio ancora più eloquente. Il ping verso quei nodi è bassissimo: 13 ms da Francoforte, 18 da Praga, 21 da New York. Eppure il TTFB misurato da Francoforte è di 86 ms e quello da Northern Virginia di 288 ms. Se la rete impiega una ventina di millisecondi per arrivare al nodo, il resto del tempo non si perde nei cavi: si perde nel nodo, o dietro il nodo, quando la pagina non è in cache e va chiesta all’origine.
La conferma arriva dalla tua stessa dashboard «Mappa Googlebot». Il 90% delle richieste di Googlebot passa dal POP di Vint Hill, in Virginia, lo stesso data center di OVH a cui puntano Montreal e New York. Hit rate della cache: 58,7%. TTFB medio: 241 ms. Nel post li attribuisci «solo all’oceano in mezzo». Ma tra Googlebot, che arriva dagli Stati Uniti, e un POP in Virginia l’oceano non c’è. Compare quando il POP non ha la pagina e deve chiederla in Europa: a giudicare da quella dashboard, circa quattro volte su dieci. L’oceano non è una fatalità geografica: è il sintomo. La causa è la cache.
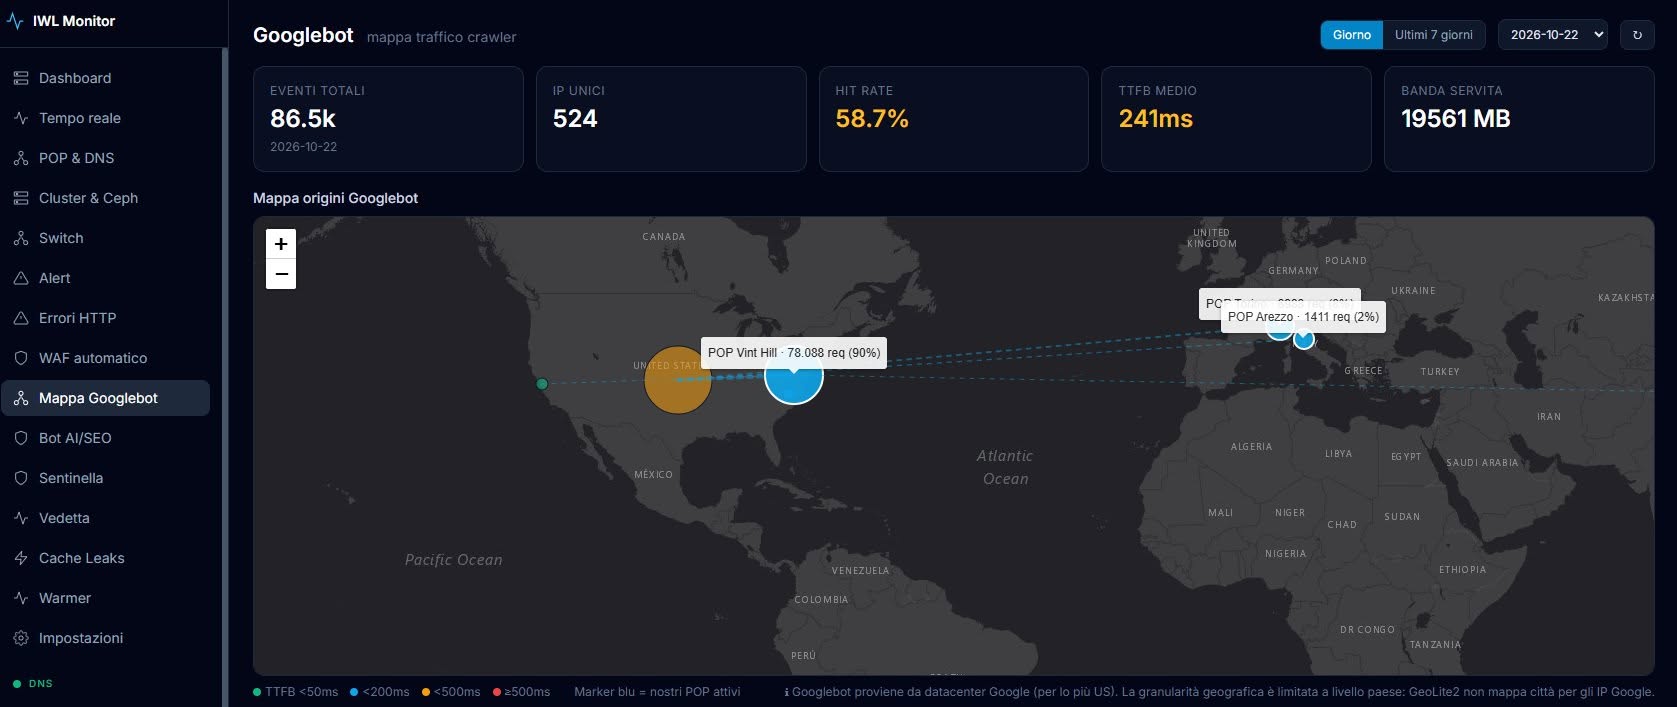
E non è un dettaglio estetico: nella documentazione sul budget di scansione Google spiega che, se i tempi di risposta del sito si allungano, il limite di scansione diminuisce e Googlebot scansiona meno. Googlebot non è un utente di Chrome: qui il CrUX non salva nessuno.
I gamberi in tempura
Sia chiaro: ammiriamo chi prova a fare le cose, qualsiasi cosa essa sia. Un paio di mesi fa abbiamo deciso di fare i gamberi in tempura. Comprato il materiale migliore, visto e letto decine di video e di guide, massima dedizione e passione. Il risultato? Immangiabile. O meglio: buono da mangiare noi, a casa, ma certamente da non servire in nessun ristorante, nemmeno nel più infimo degli All You Can Eat.
Il problema non è provare. Il problema è che, davanti a numeri del genere, non dici «ok, effettivamente non sono pronto, c’è da lavorare, ritiro l’offerta pubblica, abbasso la testa un anno e mi ripresento». No: pubblichi un post su WordPress Italia che prova a minimizzare, distorcendo perfino quello che Google consiglia. Vediamo come.
1. «Lighthouse/PageSpeed fallisce sopra i 600 ms»
Corretto. Ma stai usando una soglia diagnostica per giustificare prestazioni che possono essere ampiamente migliorate.
Google, nella documentazione ufficiale di PageSpeed Insights, ha scritto nero su bianco: «Devi ridurre il tempo di risposta del server al di sotto dei 200 ms». Quella pagina appartiene alla versione 4 di PageSpeed Insights, oggi deprecata, e lo diciamo per correttezza. Ma dimostra che Google ha sempre indicato obiettivi ben più ambiziosi dei 600 ms. I 100 ms che il post attribuisce a Google, invece, non compaiono né lì né nella documentazione di Lighthouse.
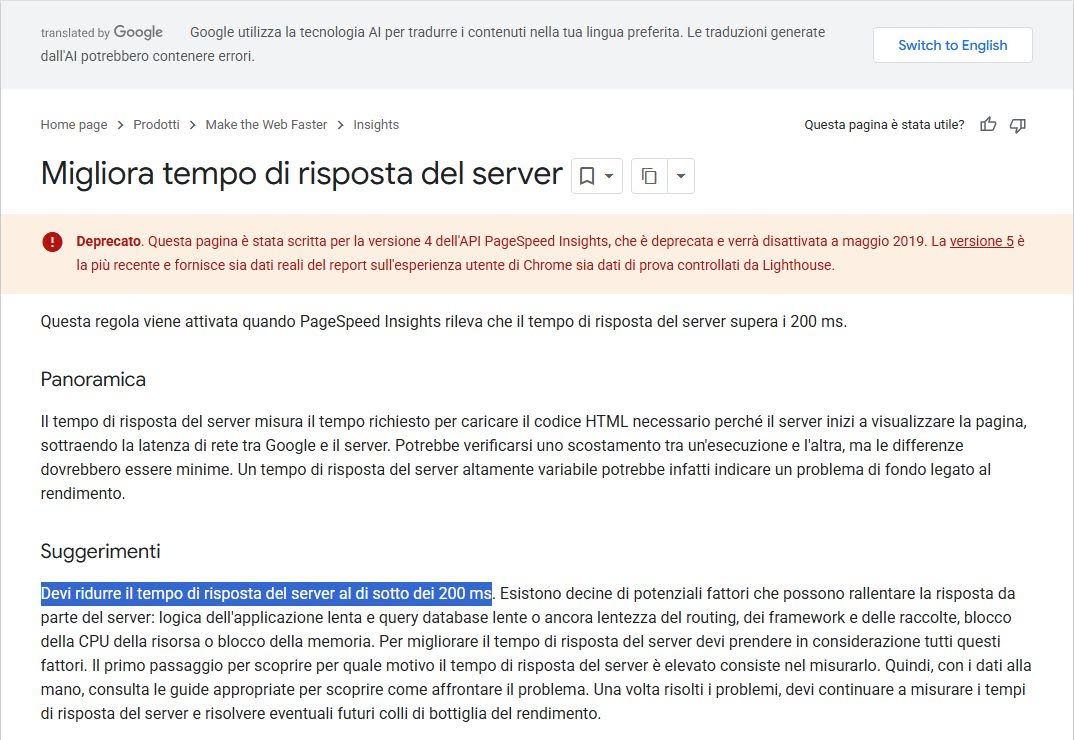
Oggi Lighthouse segnala il problema oltre i 600 ms, mentre i dati reali classificano come buono un TTFB fino a 800 ms. Ma sono tre concetti diversi: raccomandazioni di ottimizzazione, soglie diagnostiche e classificazioni statistiche dell’esperienza reale. Confonderli significa non cogliere la differenza tra ottenere una valutazione sufficiente e costruire un’infrastruttura davvero performante. Soprattutto quando si parla di connessioni a banda larga, di server geograficamente vicini e di pagine WordPress servite interamente dalla cache.
Che Google non segnali un problema sotto i 600 ms non significa affatto che un TTFB di 500 ms sia un risultato eccellente. Significa soltanto che non ha superato quella specifica soglia diagnostica. E lo screenshot di speed.host.it allegato al post ne è la prova al contrario: un singolo test di laboratorio, l’INP vuoto, e il verdetto «Core Web Vitals nella norma».
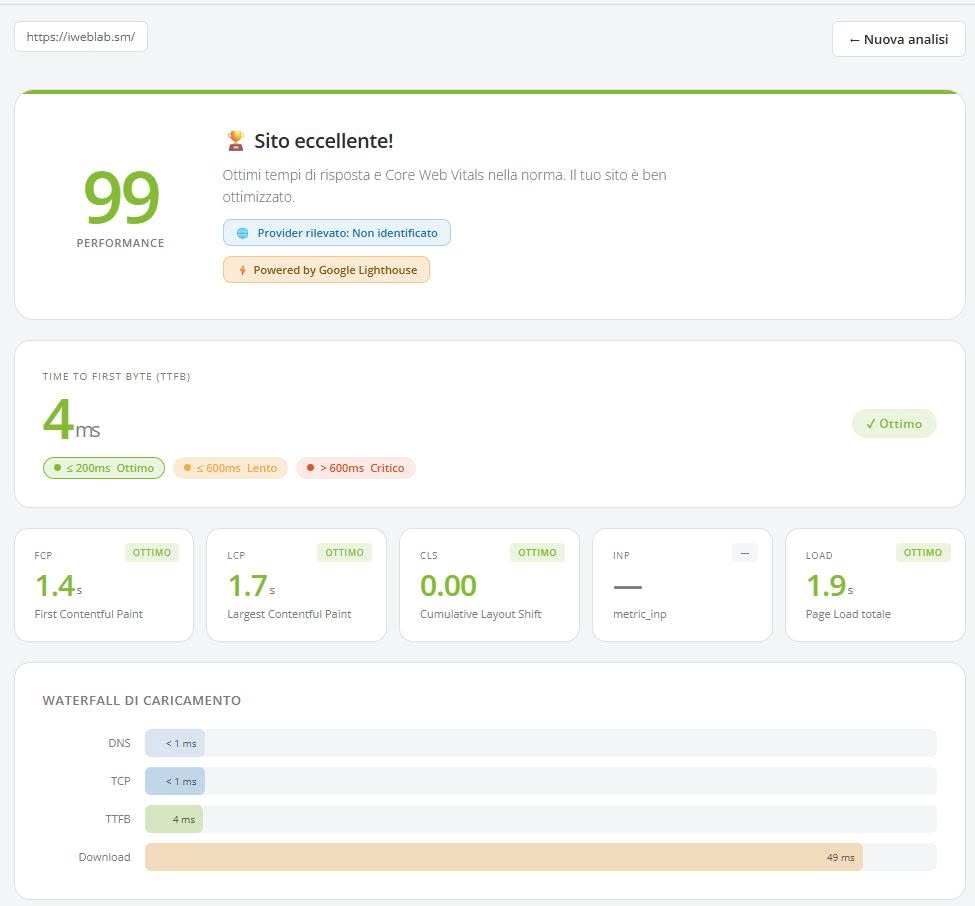
2. «Il TTFB non è nemmeno un Core Web Vital»
È forse l’affermazione più preoccupante. Non perché sia falsa, ma per ciò che lascia intendere.
Il TTFB non è uno dei tre Core Web Vitals ufficiali, che sono LCP, INP e CLS. Ma è una metrica fondamentale che viene prima di FCP e LCP: ogni millisecondo perso prima di ricevere il primo byte è un millisecondo in meno per completare il rendering della pagina. È Google stessa a spiegarlo nella sua guida al TTFB: il TTFB precede le altre metriche di caricamento, e il tempo che si accumula lì si ritrova in tutte quelle successive. Usare il fatto che non sia un Core Web Vital per ridimensionarne l’importanza significa non aver compreso il rapporto tra le metriche.
Il problema di fondo è che il post usa soglie statistiche, pensate per classificare l’esperienza degli utenti, come se fossero certificazioni della qualità tecnica di un lavoro. Sono due cose profondamente diverse. Un medico non ti dice che sei un atleta perché i tuoi valori rientrano negli intervalli di normalità. Allo stesso modo, un sistemista non dovrebbe sostenere che un’infrastruttura sia particolarmente performante soltanto perché PageSpeed Insights mostra un indicatore verde. E soprattutto, se vendi pubblicamente servizi di ottimizzazione delle prestazioni, questa differenza dovresti conoscerla perfettamente.
CrUX e LABS: due strumenti, due domande diverse
La conclusione del post è che PageSpeed e Lighthouse servono «per capire cosa sistemare», ma che «il voto vero» è il CrUX: «Il 100 è bello da mostrare. Il verde su CrUX è quello che conta». Sembra equilibrata. In realtà mette i due dati in classifica, come se uno fosse il voto e l’altro un passatempo da tecnici. Non è così: CrUX e laboratorio non misurano la stessa cosa e non servono allo stesso scopo. Lo spieghiamo per esteso in Perché CrUX e LABS servono entrambi; qui l’essenziale.
CrUX risponde alla domanda «che cosa è successo?». Raccoglie le esperienze reali degli utenti di Chrome idonei e valuta il 75° percentile: una metrica è buona se almeno tre visite su quattro rientrano nella soglia. Ma copre una finestra mobile di 28 giorni, quindi reagisce alle modifiche con settimane di ritardo; non include Chrome su iPhone né gli altri browser; e per molte pagine, o per i siti con poco traffico, i dati semplicemente non ci sono. Soprattutto, descrive il pubblico che hai oggi. Se nove visitatori su dieci navigano in fibra con smartphone recenti, una pagina può ottenere valori eccellenti anche se, in assoluto, è tutt’altro che leggera.
Il laboratorio risponde alla domanda «che cosa potrebbe succedere, e perché?». Carica la pagina con dispositivo, rete e processore simulati, in condizioni controllate e ripetibili, e la scompone: risorse che bloccano il rendering, JavaScript eccessivo, task lunghi sul thread principale, immagini sovradimensionate, catene di richieste che ritardano l’elemento LCP. Ed è l’unico che permette di confrontare prima e dopo un intervento in pochi minuti, invece di aspettare un mese. Dire che un dato di laboratorio non conta perché è sintetico è come dire che un crash test è inutile perché non riproduce ogni incidente possibile.
Mettendo insieme i due dati si vede ciò che nessuno dei due mostra da solo: il margine. Due siti con lo stesso LCP di 2 secondi nei dati reali possono essere uno ben costruito e l’altro veloce solo perché il suo pubblico ha telefoni recenti e reti velocissime. Per CrUX sono identici. Appena arriva una campagna, un picco di traffico da mobile o un nuovo mercato, il primo resta nelle soglie, il secondo no. Un CrUX verde con un laboratorio debole non è una promozione: è un sito con poco margine.
Vale anche al contrario, e qui il post inciampa. Sostiene che l’INP è vuoto perché «nessun test di laboratorio può misurarlo». La documentazione di Google sull’INP dice che l’INP può essere misurato in alcuni strumenti di laboratorio, con un valore che dipende dalle interazioni eseguite durante la misura. In Lighthouse è vuoto perché, in modalità navigazione, carica la pagina e non clicca nulla; per questo Google indica il Total Blocking Time come riferimento in laboratorio. E nel tuo stesso screenshot di PageSpeed Insights, tra gli audit, compare la voce «Suddivisione INP».
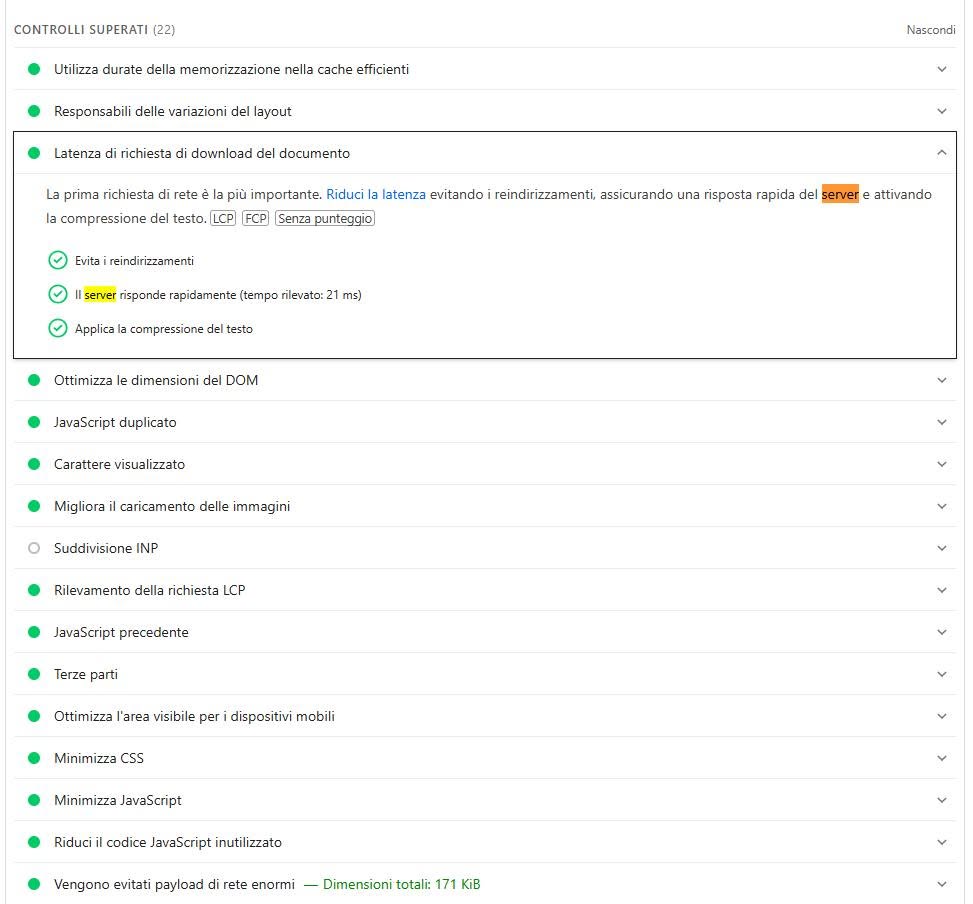
Il CrUX dice che c’è un problema. Il laboratorio dice quale, e verifica subito se la correzione funziona. Chiedersi quale dei due sia «il voto vero» è la domanda sbagliata: sostituire il culto del 100 su PageSpeed con il culto del verde su CrUX significa cambiare idolo, non metodo.
Un sistemista che fa lezione di web performance
E veniamo al punto che, a nostro avviso, spiega tutto il resto. In tutto il post non c’è una parola su JavaScript, CSS, DOM, immagini o font. Si parla di TTFB, di soglie e di POP. È il perimetro naturale di un sistemista: compressione con Brotli e zstd, HTTP/2 e HTTP/3, TLS, cache, tempi di risposta del server. Cose importanti, che facciamo anche noi ogni giorno. Ma sono una parte delle prestazioni, non le prestazioni.
I Core Web Vitals si decidono in gran parte nel browser. Il TTFB è solo la prima delle quattro fasi in cui Google scompone l’LCP; dopo vengono il ritardo e la durata del caricamento della risorsa principale e il ritardo di rendering, che dipendono da come sono costruiti HTML, CSS e immagini. L’INP dipende dal JavaScript che occupa il thread principale quando l’utente tocca lo schermo. Il CLS dipende da layout, font e contenuti inseriti in ritardo. Un TTFB di 4 ms non accorcia di un millisecondo l’esecuzione di 700 KB di JavaScript, non rimpicciolisce un DOM da diecimila nodi e non impedisce a un banner di spostare la pagina.
Per questo parlare di web performance dal solo punto di vista del sistemista, fermandosi a zstd, Brotli e TTFB e tralasciando tutta l’ottimizzazione applicativa di DOM, JavaScript e CSS, è limitante. E quando lo si fa per insegnare agli altri quali dati contano davvero, è un chiaro sconfinamento di competenze. La velocità di un sito nasce dall’insieme: un server veloce è il punto di partenza, un’applicazione efficiente completa il lavoro. Chi conosce solo metà della catena finisce, inevitabilmente, per dire che l’altra metà non conta.
Una materia difficile, anche per chi la vende
Questa vicenda dimostra una cosa sola: le prestazioni web sono una materia difficile anche per gli addetti ai lavori, sistemisti e sviluppatori compresi. Soglie diagnostiche scambiate per obiettivi, statistiche scambiate per certificazioni, un oceano chiamato in causa dove ci sono cache miss, il laboratorio liquidato come un passatempo e l’applicazione dimenticata del tutto. Chi deve scegliere a chi affidare il proprio sito dovrebbe pretendere dati da più località, soglie citate dalla fonte, un intervento che vada dal server al browser e un confronto onesto prima e dopo. È quello che facciamo noi. Senza scorciatoie e senza barare.
Fonti: Google, Migliora tempo di risposta del server (PageSpeed Insights v4, deprecata); web.dev, Time to First Byte (TTFB); Chrome for Developers, Lighthouse: tempo di risposta del server; web.dev, Ottimizzare il Largest Contentful Paint; web.dev, Interaction to Next Paint (INP); Google Search Central, Gestione del budget di scansione; iWebLab, iWebLab Cache. Proprietà degli indirizzi IP verificate tramite whois. Le immagini di iweblab.sm sono gli screenshot allegati al post originale e ai test pubblici citati, riprodotti a scopo di commento.