Ottimizzare un sito è difficile; mantenerlo ottimizzato lo è ancora di più. Chi ha seguito un progetto di prestazioni conosce bene la sequenza: settimane di lavoro, Core Web Vitals finalmente nello stato buono, soddisfazione generale. Poi, mese dopo mese, arrivano un nuovo plugin per le recensioni, un pixel per una campagna, un carosello nella home, un font aggiuntivo per un titolo, uno script di chat. Nessuno di questi interventi, da solo, sembra grave. Dopo un anno il sito è tornato lento quanto prima, e nessuno sa esattamente quando e perché.
Il budget di prestazioni è lo strumento che interrompe questa sequenza. È un insieme di limiti espliciti, concordati e verificati automaticamente, su ciò che una pagina può pesare e su come deve comportarsi. Non impedisce al sito di evolvere, ma rende visibile il costo di ogni aggiunta e obbliga a decidere consapevolmente quando lo si vuole superare. In questo articolo vediamo quali tipi di budget esistono, come definirli, come controllarli in modo automatico e come farli funzionare nell’organizzazione.
Perché i siti tornano lenti
Il peggioramento delle prestazioni nel tempo non è un incidente, ma una tendenza naturale. Ogni reparto ha buone ragioni per aggiungere qualcosa: il marketing un nuovo strumento di tracciamento, il commerciale una chat, il design un’animazione, i contenuti immagini più grandi e video incorporati. Ogni aggiunta porta un beneficio visibile a chi la chiede e un costo in prestazioni distribuito su tutti, poco visibile e difficile da attribuire. Senza un meccanismo che renda quel costo esplicito, la somma delle decisioni ragionevoli produce un sito lento.
C’è anche un problema di tempi. I dati di campo del Chrome UX Report, quelli che contano per Google, si aggiornano su una finestra di 28 giorni: un peggioramento introdotto oggi diventa pienamente visibile dopo settimane, quando nel frattempo sono stati fatti altri rilasci e la causa è difficile da isolare. Un budget controllato a ogni rilascio individua il problema nel momento in cui viene introdotto, quando è ancora facile risalire a chi l’ha causato e perché.
Tre tipi di budget
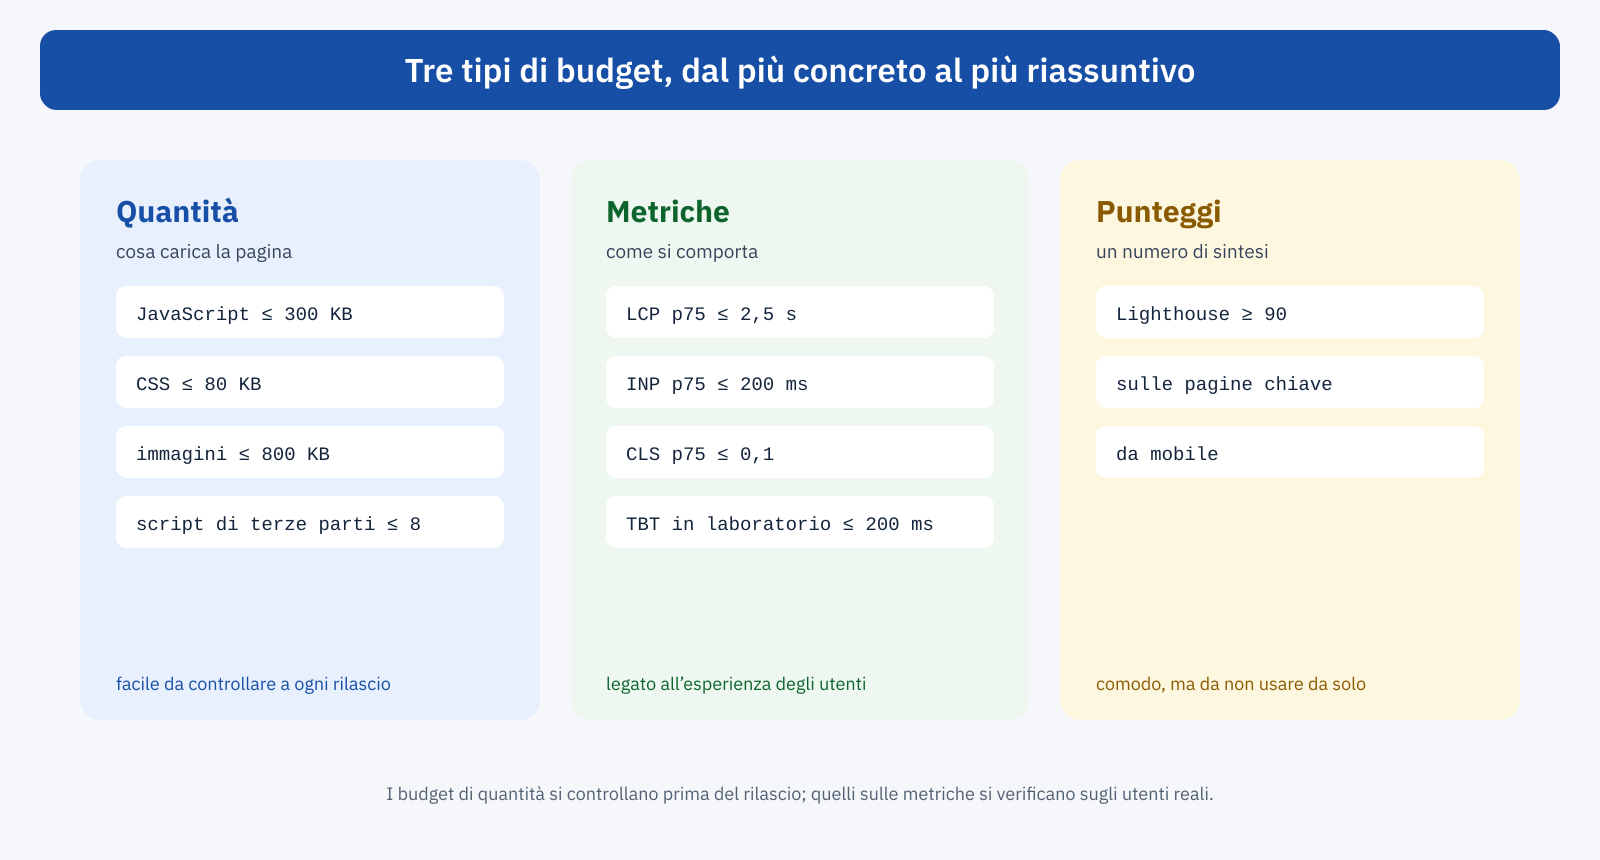
I budget di prestazioni si dividono in tre famiglie, ciascuna con vantaggi e limiti diversi. In pratica si usano insieme.
Budget di quantità
I budget di quantità fissano limiti su ciò che la pagina carica: kilobyte di JavaScript, di CSS, di immagini e di font, numero di richieste, numero di domini o di script di terze parti. Sono i più concreti e i più facili da comprendere per tutti: «il JavaScript della scheda prodotto non deve superare i 300 kilobyte compressi» è una regola che un designer, uno sviluppatore e un responsabile marketing capiscono allo stesso modo. Sono anche facili da controllare in modo automatico e stabile, perché non dipendono dalla variabilità della rete o del dispositivo di test.
Il limite è che misurano una causa, non un effetto: una pagina può rispettare il budget di JavaScript ed essere comunque lenta per un server senza cache o un’immagine principale caricata tardi. Per questo vanno affiancati da budget sulle metriche.
Budget sulle metriche
I budget sulle metriche fissano limiti sui tempi: LCP, INP e CLS al 75° percentile dei dati di campo, oppure valori di laboratorio come LCP e Total Blocking Time misurati in un test controllato. Sono direttamente legati all’esperienza degli utenti e agli obiettivi di business, e il punto di partenza naturale sono le soglie delle Core Web Vitals. Il limite è la variabilità: i test di laboratorio oscillano da un’esecuzione all’altra, e i dati di campo arrivano con ritardo. Richiedono quindi più attenzione nella configurazione, per esempio ripetendo i test più volte e usando la mediana.
Budget sui punteggi
I budget sui punteggi fissano un minimo per un indice sintetico, come il punteggio di prestazioni di Lighthouse. Sono comodi da comunicare, ma un punteggio aggrega molte metriche con pesi che cambiano tra le versioni dello strumento, e può essere migliorato con tecniche che non migliorano l’esperienza reale, come abbiamo visto parlando del cloaking delle prestazioni. Possono affiancare gli altri budget, ma non sostituirli.
Come definire i limiti
Un budget utile non è né troppo generoso, perché non protegge nulla, né troppo severo, perché viene ignorato alla prima difficoltà. Alcuni criteri aiutano a trovare il giusto equilibrio.
- Partire dalla situazione attuale. Se il sito è già nello stato buono, il budget iniziale può essere la situazione attuale con un piccolo margine: l’obiettivo è non peggiorare. Se non lo è, si fissa un budget raggiungibile e lo si abbassa gradualmente man mano che gli interventi producono risultati.
- Lavorare a ritroso dalle metriche. Per ottenere un LCP di 2,5 secondi su una rete mobile di riferimento, quanti kilobyte può pesare il percorso critico? Il calcolo, anche approssimativo, trasforma un obiettivo di tempo in limiti di quantità verificabili.
- Guardare i concorrenti. Le prestazioni dei principali concorrenti, misurate con gli stessi strumenti, sono un riferimento utile, soprattutto per convincere chi decide: essere più veloci dei concorrenti è un argomento che si capisce facilmente.
- Distinguere per modello di pagina. Una home, una scheda prodotto e un articolo hanno esigenze diverse. Un budget unico per tutto il sito è troppo largo per alcune pagine e troppo stretto per altre.
- Pensare al mobile. I limiti vanno fissati per le condizioni più difficili, uno smartphone di fascia media su rete mobile: è lì che si misurano le Core Web Vitals più critiche.
Il controllo automatico prima del rilascio
Un budget che si controlla a mano, ogni tanto, finisce presto per essere dimenticato. Il suo valore sta nel controllo automatico, eseguito a ogni modifica del sito prima che arrivi in produzione. Lo strumento più diffuso è Lighthouse CI, che esegue Lighthouse su un elenco di pagine, confronta i risultati con le soglie configurate e segnala, o blocca, i rilasci che le superano.
{
	"ci": {
		"collect": {
			"url": [
				"https://staging.esempio.it/",
				"https://staging.esempio.it/categoria/scarpe/",
				"https://staging.esempio.it/prodotto/scarpa-trail/"
			],
			"numberOfRuns": 3
		},
		"assert": {
			"assertions": {
				"largest-contentful-paint": [ "error", { "maxNumericValue": 2500 } ],
				"cumulative-layout-shift": [ "error", { "maxNumericValue": 0.1 } ],
				"total-blocking-time": [ "warn", { "maxNumericValue": 200 } ],
				"resource-summary:script:size": [ "error", { "maxNumericValue": 300000 } ],
				"resource-summary:stylesheet:size": [ "warn", { "maxNumericValue": 80000 } ],
				"resource-summary:third-party:count": [ "warn", { "maxNumericValue": 8 } ]
			}
		}
	}
}
Nell’esempio, il file di configurazione lighthouserc.json indica tre pagine rappresentative dei principali modelli, ripete ogni test tre volte per ridurre la variabilità, e fissa due livelli di severità: gli errori bloccano il rilascio, gli avvisi lo segnalano senza bloccarlo. Una buona pratica è partire con tutti i controlli in modalità avviso, osservare per qualche settimana la variabilità dei risultati, e solo dopo trasformare in errori i limiti più stabili, come quelli sul peso delle risorse.
Il controllo si integra nel sistema di integrazione continua usato dal progetto. Con GitHub Actions, per esempio, bastano poche righe:
name: Budget di prestazioni
on: [ pull_request ]
jobs:
  lighthouse:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - run: npm ci && npm run build && npm run deploy:staging
      - run: npx @lhci/cli autorun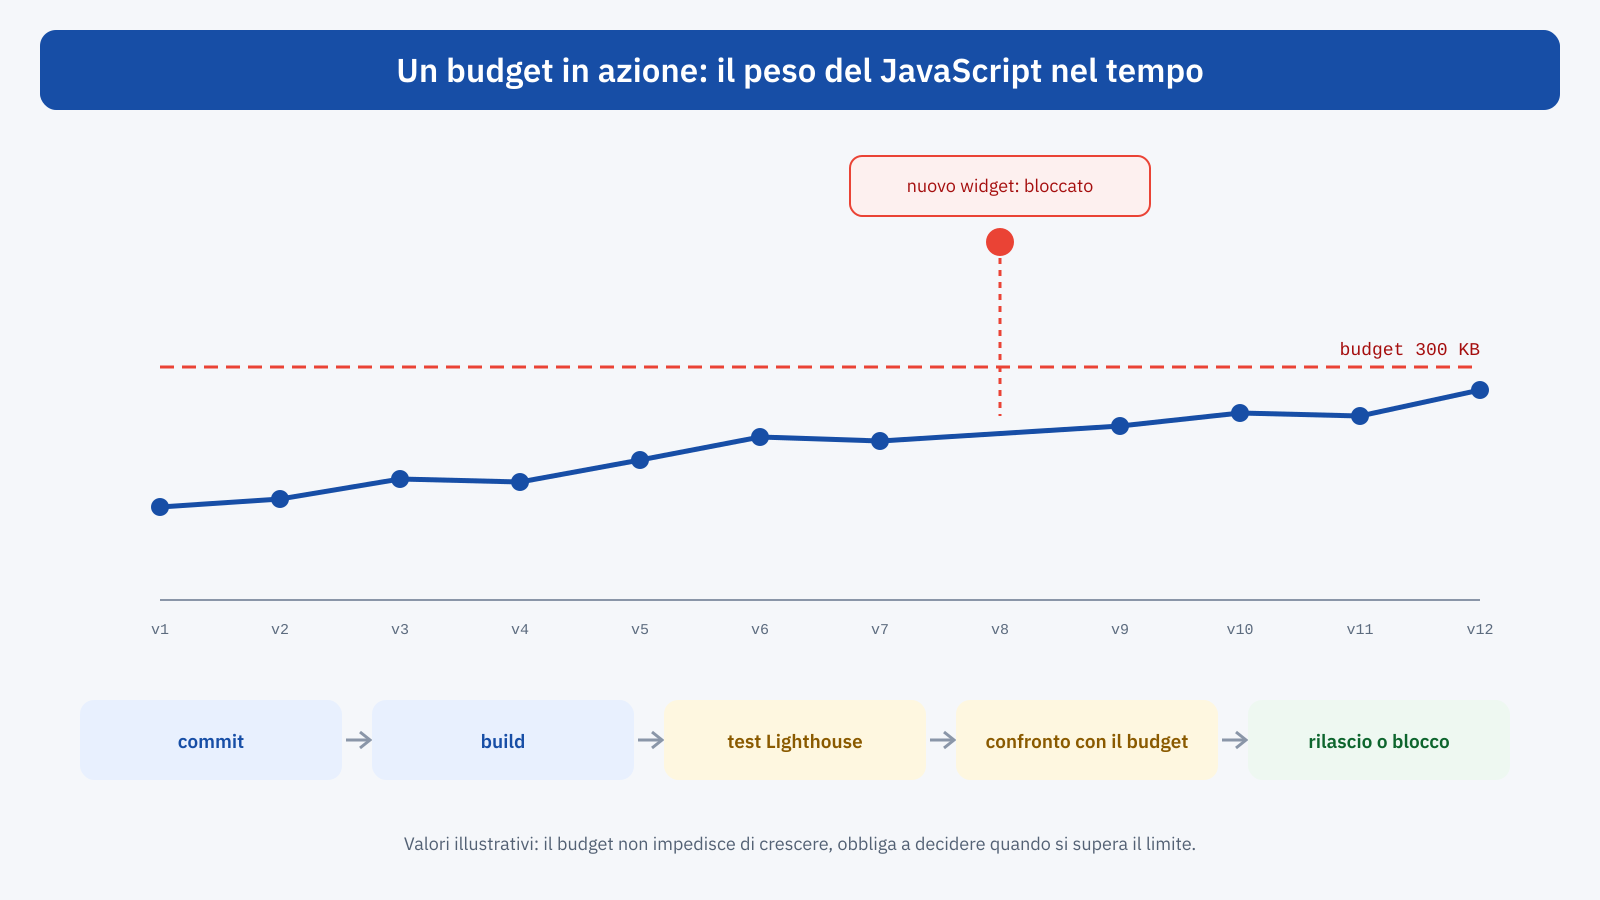
Per i progetti con un processo di compilazione del front-end esistono anche controlli più mirati, eseguiti direttamente sui file prodotti: strumenti come size-limit, o gli avvisi sulle dimensioni dei pacchetti dei principali bundler, segnalano immediatamente quando una nuova dipendenza fa crescere il JavaScript oltre il limite, prima ancora di eseguire un test nel browser.
Il controllo dopo il rilascio
I controlli prima del rilascio vedono solo ciò che passa dal codice. Molti peggioramenti, però, arrivano da fuori: un tag aggiunto dal marketing tramite il tag manager, un widget di terze parti che si aggiorna, un’immagine enorme caricata da un redattore, una campagna che porta traffico da dispositivi più lenti. Per questi serve un secondo livello di controllo, sui dati degli utenti reali.
Un sistema di Real User Monitoring permette di impostare avvisi sul 75° percentile delle metriche per modello di pagina: se l’LCP delle schede prodotto da mobile supera la soglia per due giorni consecutivi, o peggiora di più del 10% rispetto alla settimana precedente, qualcuno riceve una notifica. Anche un semplice controllo periodico dei dati della CrUX API, con un confronto settimanale, è meglio di niente. L’obiettivo è accorgersi di un problema in giorni, non in mesi.
Budget per ciò che non passa dal codice
Alcune delle fonti di peggioramento più comuni non sono controllabili da un test automatico sul codice, e richiedono regole di processo. Le principali sono due.
La prima sono gli script di terze parti. Un budget sul numero e sul peso degli script esterni, con un registro di chi li ha richiesti, a cosa servono e fino a quando, trasforma l’aggiunta di un nuovo tag da gesto automatico a decisione: se si vuole aggiungere uno strumento oltre il limite, se ne rimuove un altro o si giustifica l’eccezione. Il tag manager, che permette di aggiungere script senza passare dagli sviluppatori, è il punto in cui questa regola va applicata.
La seconda sono i contenuti. Immagini caricate a piena risoluzione, video incorporati senza facciata, sezioni della home costruite con blocchi pesanti. In WordPress alcune regole possono essere applicate automaticamente, come il ridimensionamento delle immagini troppo grandi al caricamento, che il core applica già oltre una certa soglia di dimensione, e la conversione nei formati moderni. Per il resto servono linee guida semplici per i redattori e un controllo periodico delle pagine più visitate.
Cosa succede quando il budget viene superato
Un budget ha senso solo se superarlo ha conseguenze, e le conseguenze vanno decise prima. Le opzioni sono tre: ottimizzare la nuova funzione finché rientra nel limite; rimuovere qualcos’altro per fare spazio; accettare consapevolmente il superamento, aggiornando il budget con una motivazione esplicita. Tutte e tre sono legittime. Ciò che il budget impedisce è la quarta opzione, quella più comune senza un budget: superare il limite senza accorgersene.
Perché questo funzioni serve un responsabile: una persona o un gruppo che custodisce i budget, decide sulle eccezioni e ne rende conto. Senza un responsabile, il primo superamento urgente, magari alla vigilia di una campagna, diventa il precedente che svuota la regola. Legare i budget a obiettivi di business, come mostrato nell’articolo sul ritorno economico delle Web Performance, rende molto più semplice difenderli quando qualcuno chiede di superarli.
Un esempio di partenza
Per un sito WordPress di medie dimensioni, un insieme iniziale ragionevole potrebbe essere questo, da adattare alla situazione reale:
- JavaScript compresso per pagina: al massimo 300 kilobyte, di cui non più di 100 di terze parti.
- CSS compresso per pagina: al massimo 80 kilobyte.
- Immagine principale: al massimo 150 kilobyte nel formato servito da mobile.
- Font: al massimo due famiglie, quattro file.
- Laboratorio da mobile, mediana di tre esecuzioni: LCP entro 2,5 secondi, TBT entro 200 millisecondi, CLS entro 0,1.
- Campo, 75° percentile per modello di pagina: tutte le Core Web Vitals nello stato buono, con avviso per peggioramenti superiori al 10% settimanale.
In sintesi
I siti tendono a tornare lenti perché ogni aggiunta ha un beneficio visibile e un costo nascosto. Il budget di prestazioni rende quel costo esplicito: limiti su quantità, metriche e, con cautela, punteggi, definiti per modello di pagina e per le condizioni del mobile, controllati automaticamente prima di ogni rilascio con strumenti come Lighthouse CI e sorvegliati dopo il rilascio con i dati degli utenti reali.
La parte tecnica è la più semplice. Il budget funziona davvero quando ha un responsabile, regole chiare per le eccezioni e copre anche ciò che non passa dal codice, come script di terze parti e contenuti. È il passaggio che trasforma un progetto di ottimizzazione, che prima o poi finisce, in una qualità del sito che si mantiene nel tempo.